HyperTier
Proyecto propio de código abierto. Un runtime de inferencia con memoria por niveles para correr modelos de IA grandes en GPU pequeñas. En desarrollo temprano; la medición de hardware ya está hecha.
- Rol
- Autoría y mantenimiento
- Periodo
- nov 2026 — Actualidad
- Estado
- En curso
- Tecnologías
- Python
- PyTorch
- CUDA
- pytest
- GitHub Actions
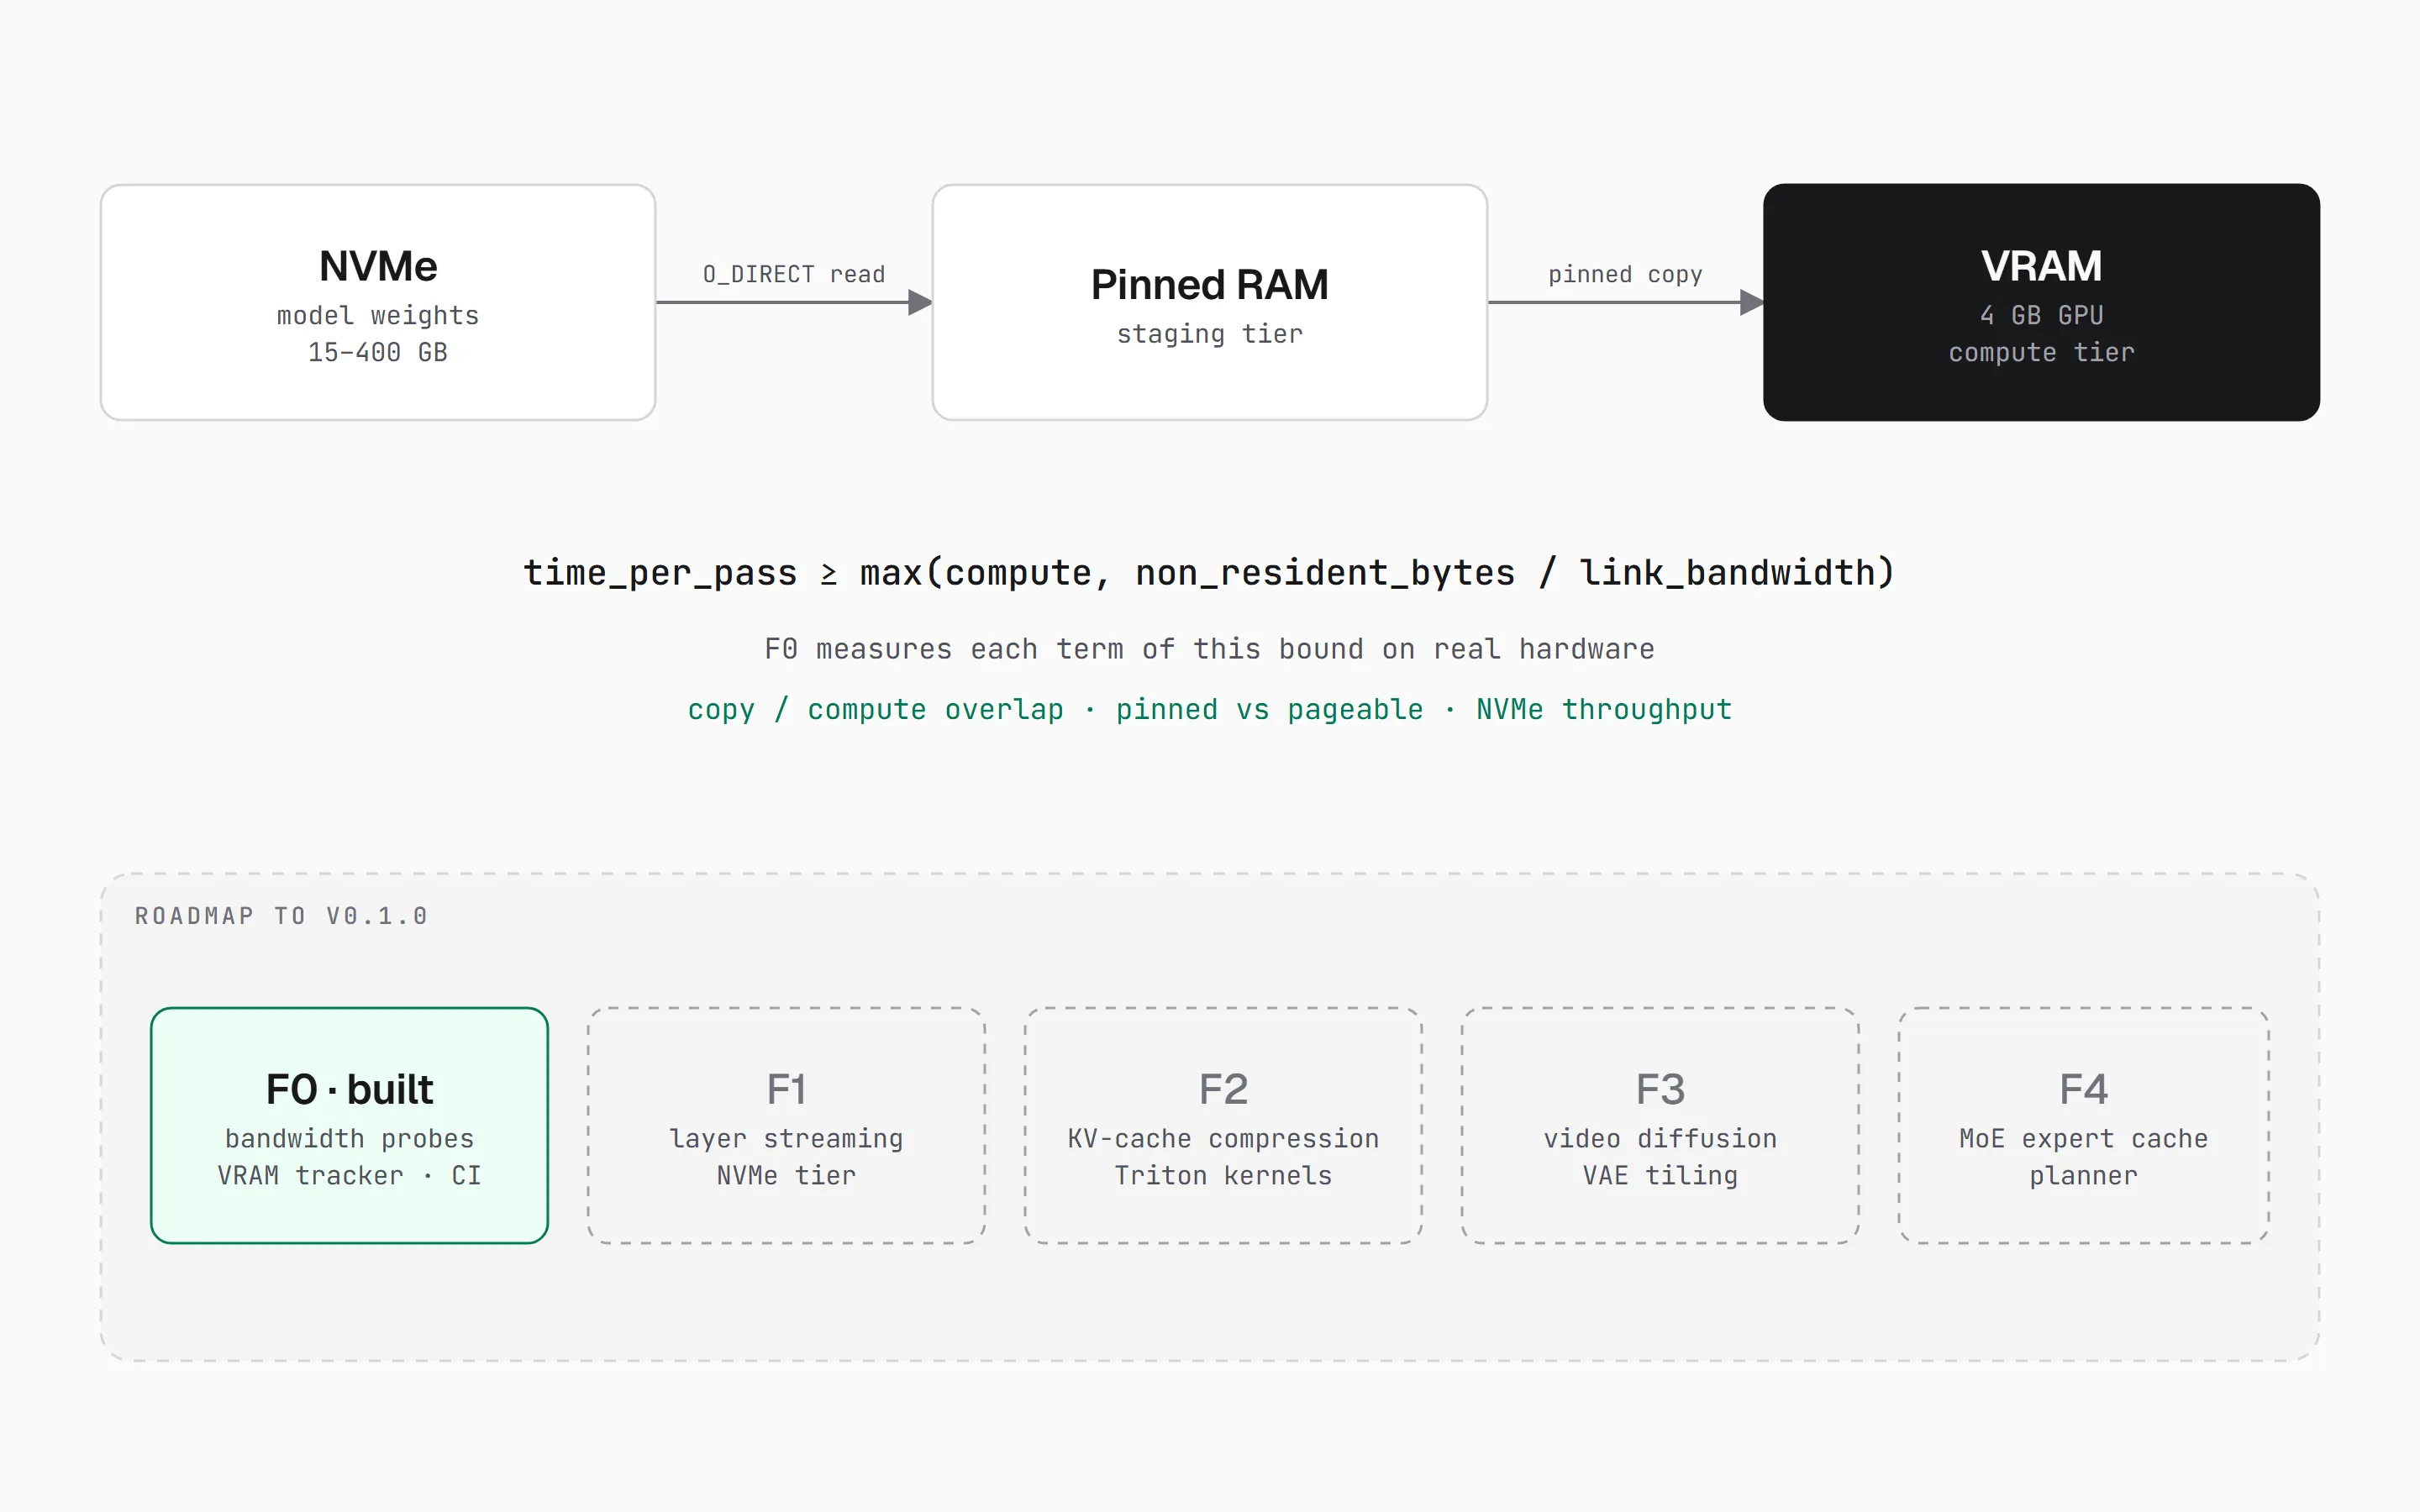
HyperTier es un proyecto propio y nace de un dolor real: los modelos que vale la pena correr son mucho más grandes que la GPU que tiene la mayoría. El diseño es un runtime de inferencia con memoria por niveles, que mantiene en VRAM solo lo que una pasada necesita y trae el resto desde RAM fijada y NVMe, solapando las transferencias con el cómputo.
Está en desarrollo temprano. El repositorio contiene la primera fase de la hoja de ruta, y el paquete en PyPI reserva el nombre hasta la primera versión funcional.
La idea central
El cuello de botella es el ancho de banda, no la capacidad:
time_per_pass ≥ max(compute, non_resident_bytes / link_bandwidth)
Antes de escribir un runtime hay que medir cada término de esa cota en el hardware objetivo. Eso es lo que hace la primera fase.
Qué está construido (fase F0)
- Sondas de ancho de banda. Copias de RAM a VRAM, memoria fijada frente a paginable, de 1 MiB a 1 GiB. Se cronometran con eventos CUDA tras un calentamiento y se reportan como mediana y percentil 90.
- Solape de copia y cómputo. Una copia fijada en su propio stream de CUDA corre contra multiplicaciones de matrices en el stream por defecto, para medir cuánto de una transferencia puede ocultarse detrás del cómputo.
- Lecturas NVMe con
O_DIRECThacia buffers alineados a página o fijados, comprobando que no responda la caché de páginas. - Sonda del límite de memoria fijada. Aumenta las reservas y retrocede ante un fallo, manteniendo un margen de RAM libre.
- Rastreador de VRAM. Un gestor de contexto que registra el pico del asignador frente a la memoria libre que reporta el driver.
- CLI de benchmark que escribe un perfil de hardware en JSON anonimizado.
Práctica de ingeniería
- El código de GPU se prueba sin GPU: imports diferidos, asignadores inyectables y un marcador de test
cudaque se omite solo. - El CI ejecuta lint, tests y construcción del paquete en Python 3.10 a 3.13.
- Apache-2.0, con cabeceras SPDX y política de seguridad.
Qué sigue
El streaming de capas, la compresión de la caché KV, los kernels en Triton, el soporte de difusión de video y la caché de expertos MoE son las fases F1 a F4 de la hoja de ruta. Aún no hay cifras de velocidad con modelos; llegarán con la primera versión del runtime.