LocalSpeakerTranscriber
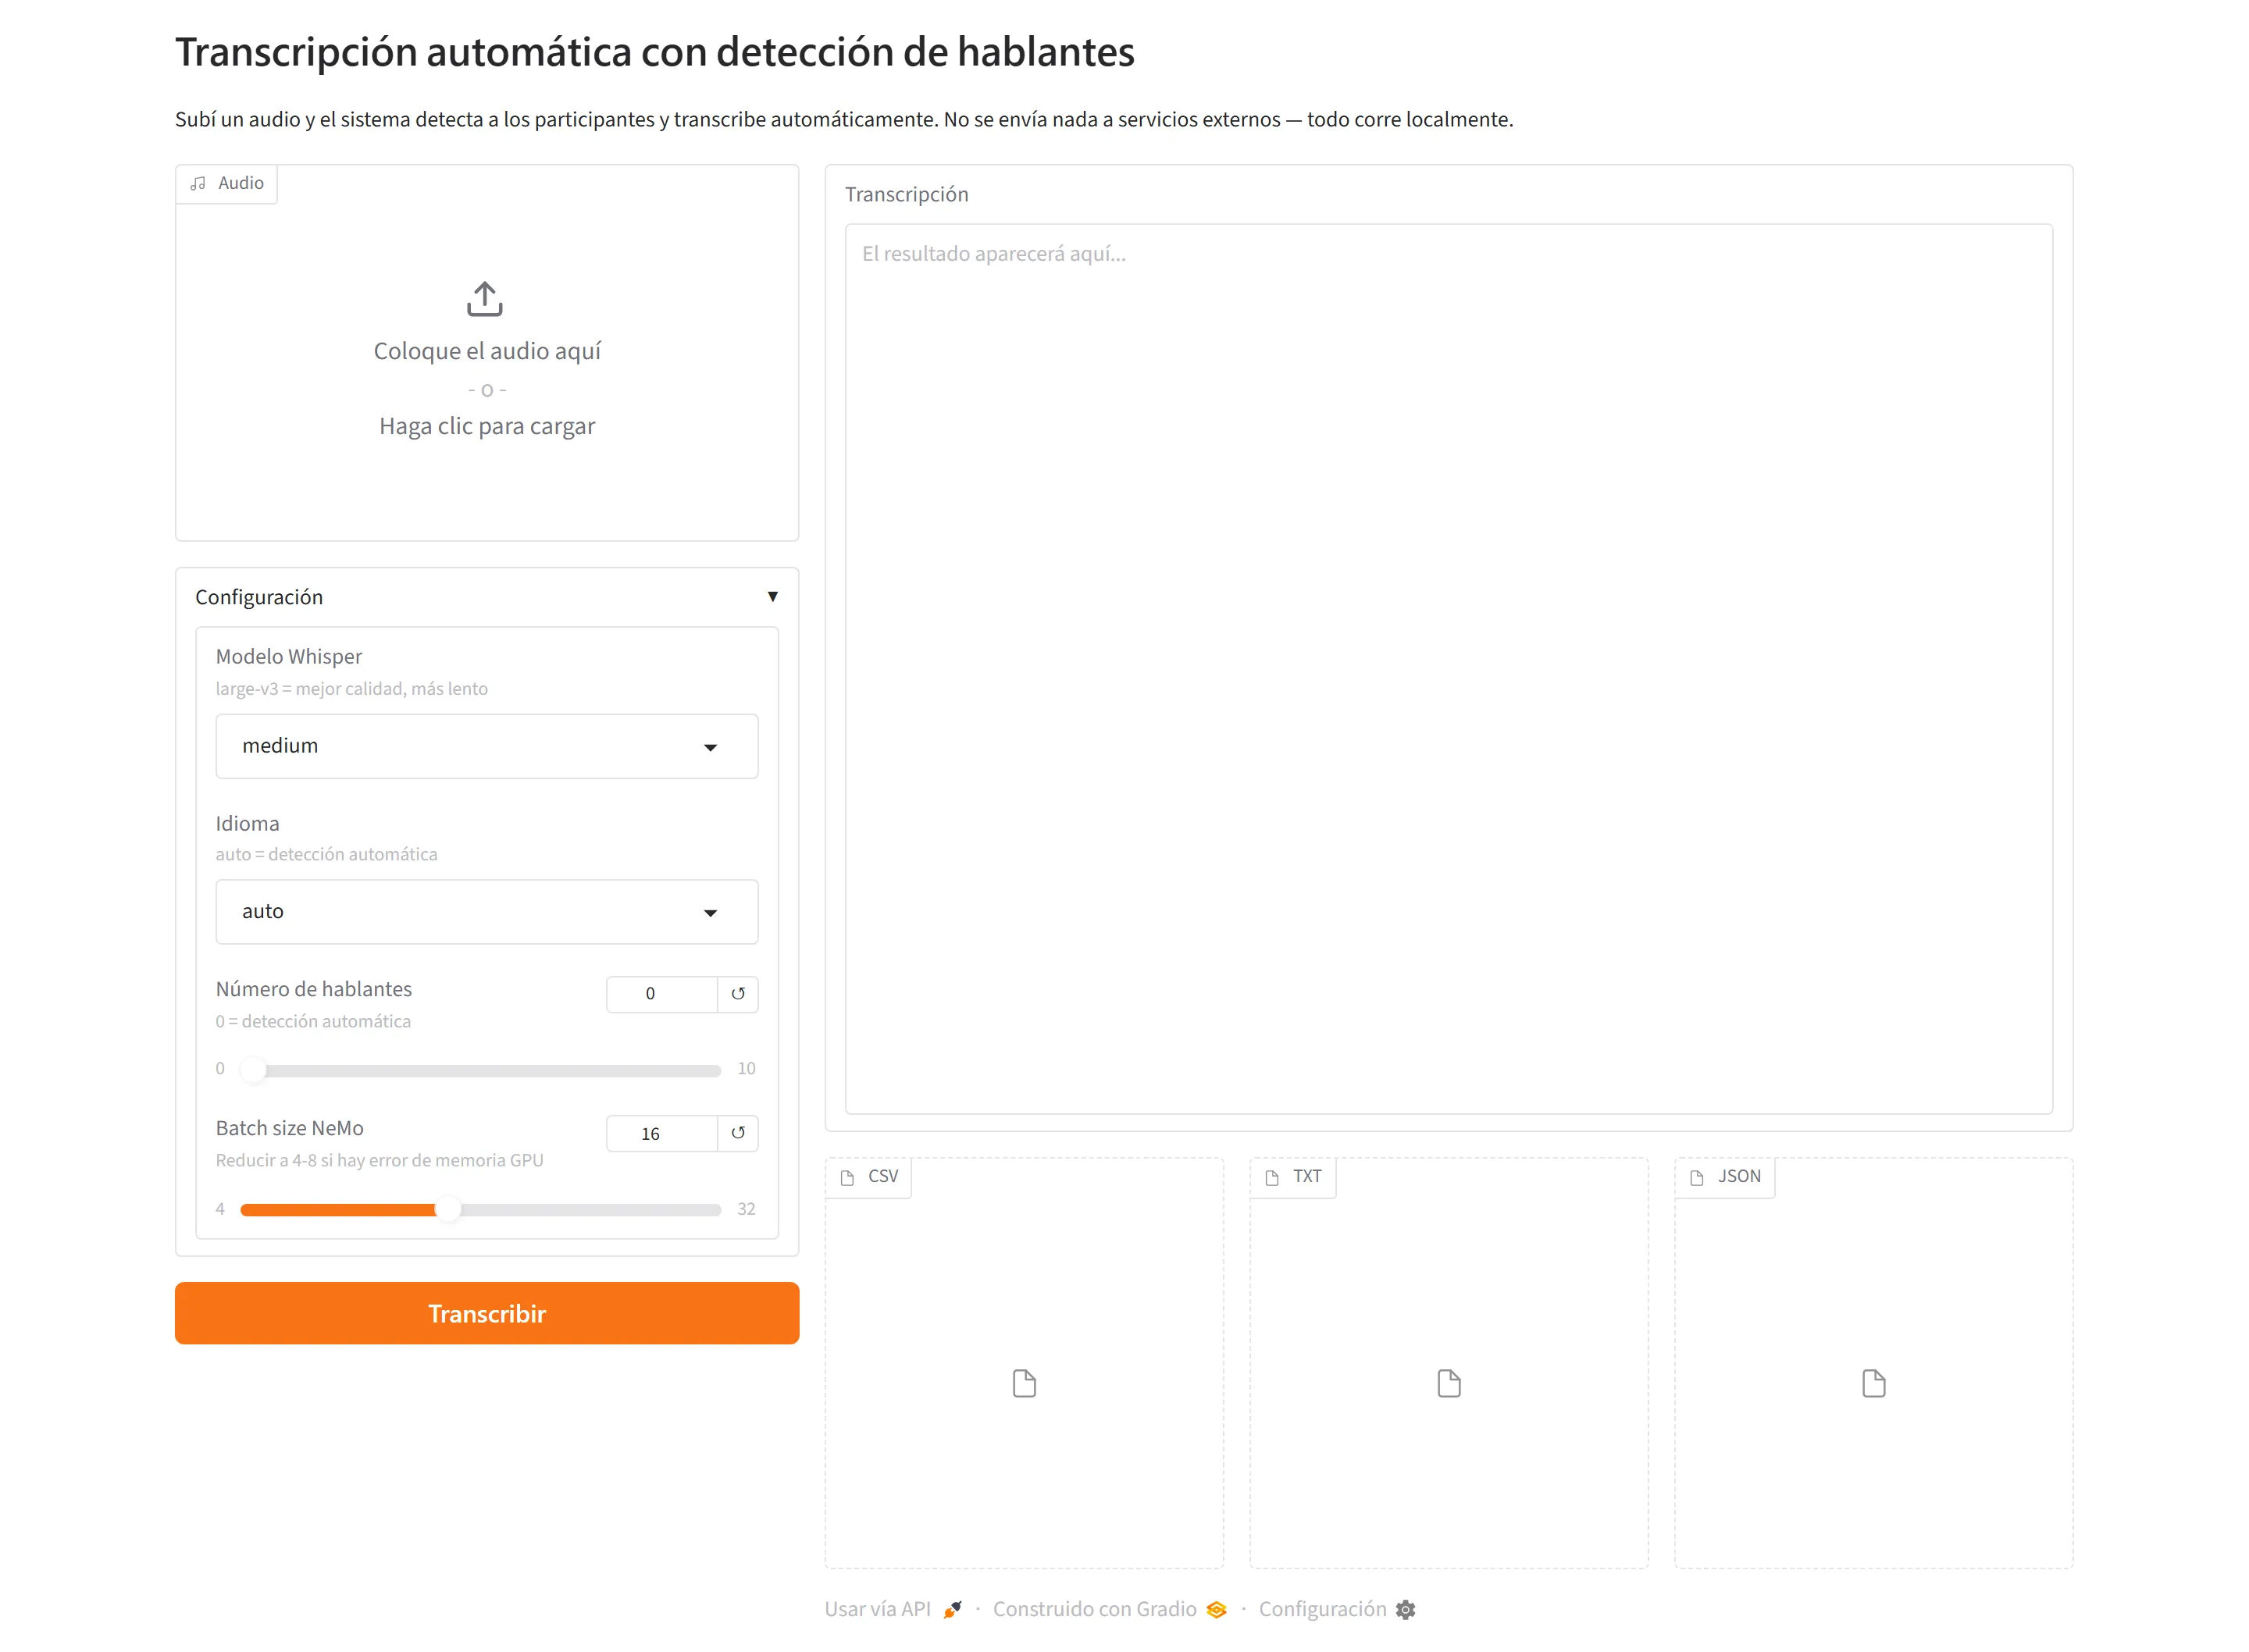
Pipeline local que convierte una grabación de audio en una transcripción atribuida a cada hablante, sin enviar el audio a servicios externos.
- Rol
- Autoría
- Periodo
- jun 2026
- Estado
- Completado
- Tecnologías
- Python
- faster-whisper
- NVIDIA NeMo
- Gradio
- ffmpeg
Una herramienta personal. Recibe una grabación y produce una transcripción en la que cada línea lleva un hablante, una marca de tiempo y un valor de confianza. Todo corre en local; los modelos se descargan una sola vez, en el primer uso.
Cómo funciona
- Preparación del audio.
ffprobeinspecciona el archivo yffmpeglo convierte a 16 kHz mono, con una comprobación de duración al final. - Diarización. El diarizador por clustering de NVIDIA NeMo decide quién habla y cuándo, con MarbleNet para la actividad de voz, embeddings de TitaNet y clustering espectral.
- Transcripción. faster-whisper produce segmentos de texto con tiempos.
- Alineación. Este paso es propio. Para cada segmento de texto suma el solape con cada hablante y elige el mayor. Registra un valor de confianza, marca los segmentos ambiguos junto con el segundo candidato y deja como desconocidos los que no solapan con nadie.
- Salidas. Un CSV, un JSON, un reporte en Markdown con la participación de cada hablante y avisos de baja confianza, y un archivo de texto en forma de diálogo.
Tiene una línea de comandos con nueve subcomandos y una interfaz Gradio que solo escucha en localhost.
Práctica de ingeniería
- Los imports de aprendizaje automático son diferidos, así que la línea de comandos, la alineación y las exportaciones corren y se prueban sin PyTorch.
- Un script de instalación para Windows con opción CUDA o CPU, y una guía de solución de problemas.
Límites
Los hablantes se atribuyen por segmento, no por palabra, y el habla solapada se ignora. No he publicado cifras de precisión ni de velocidad. Los modelos son de NVIDIA y Whisper de OpenAI; mi trabajo es el pipeline que los rodea.