Analítica del mercado de Airbnb
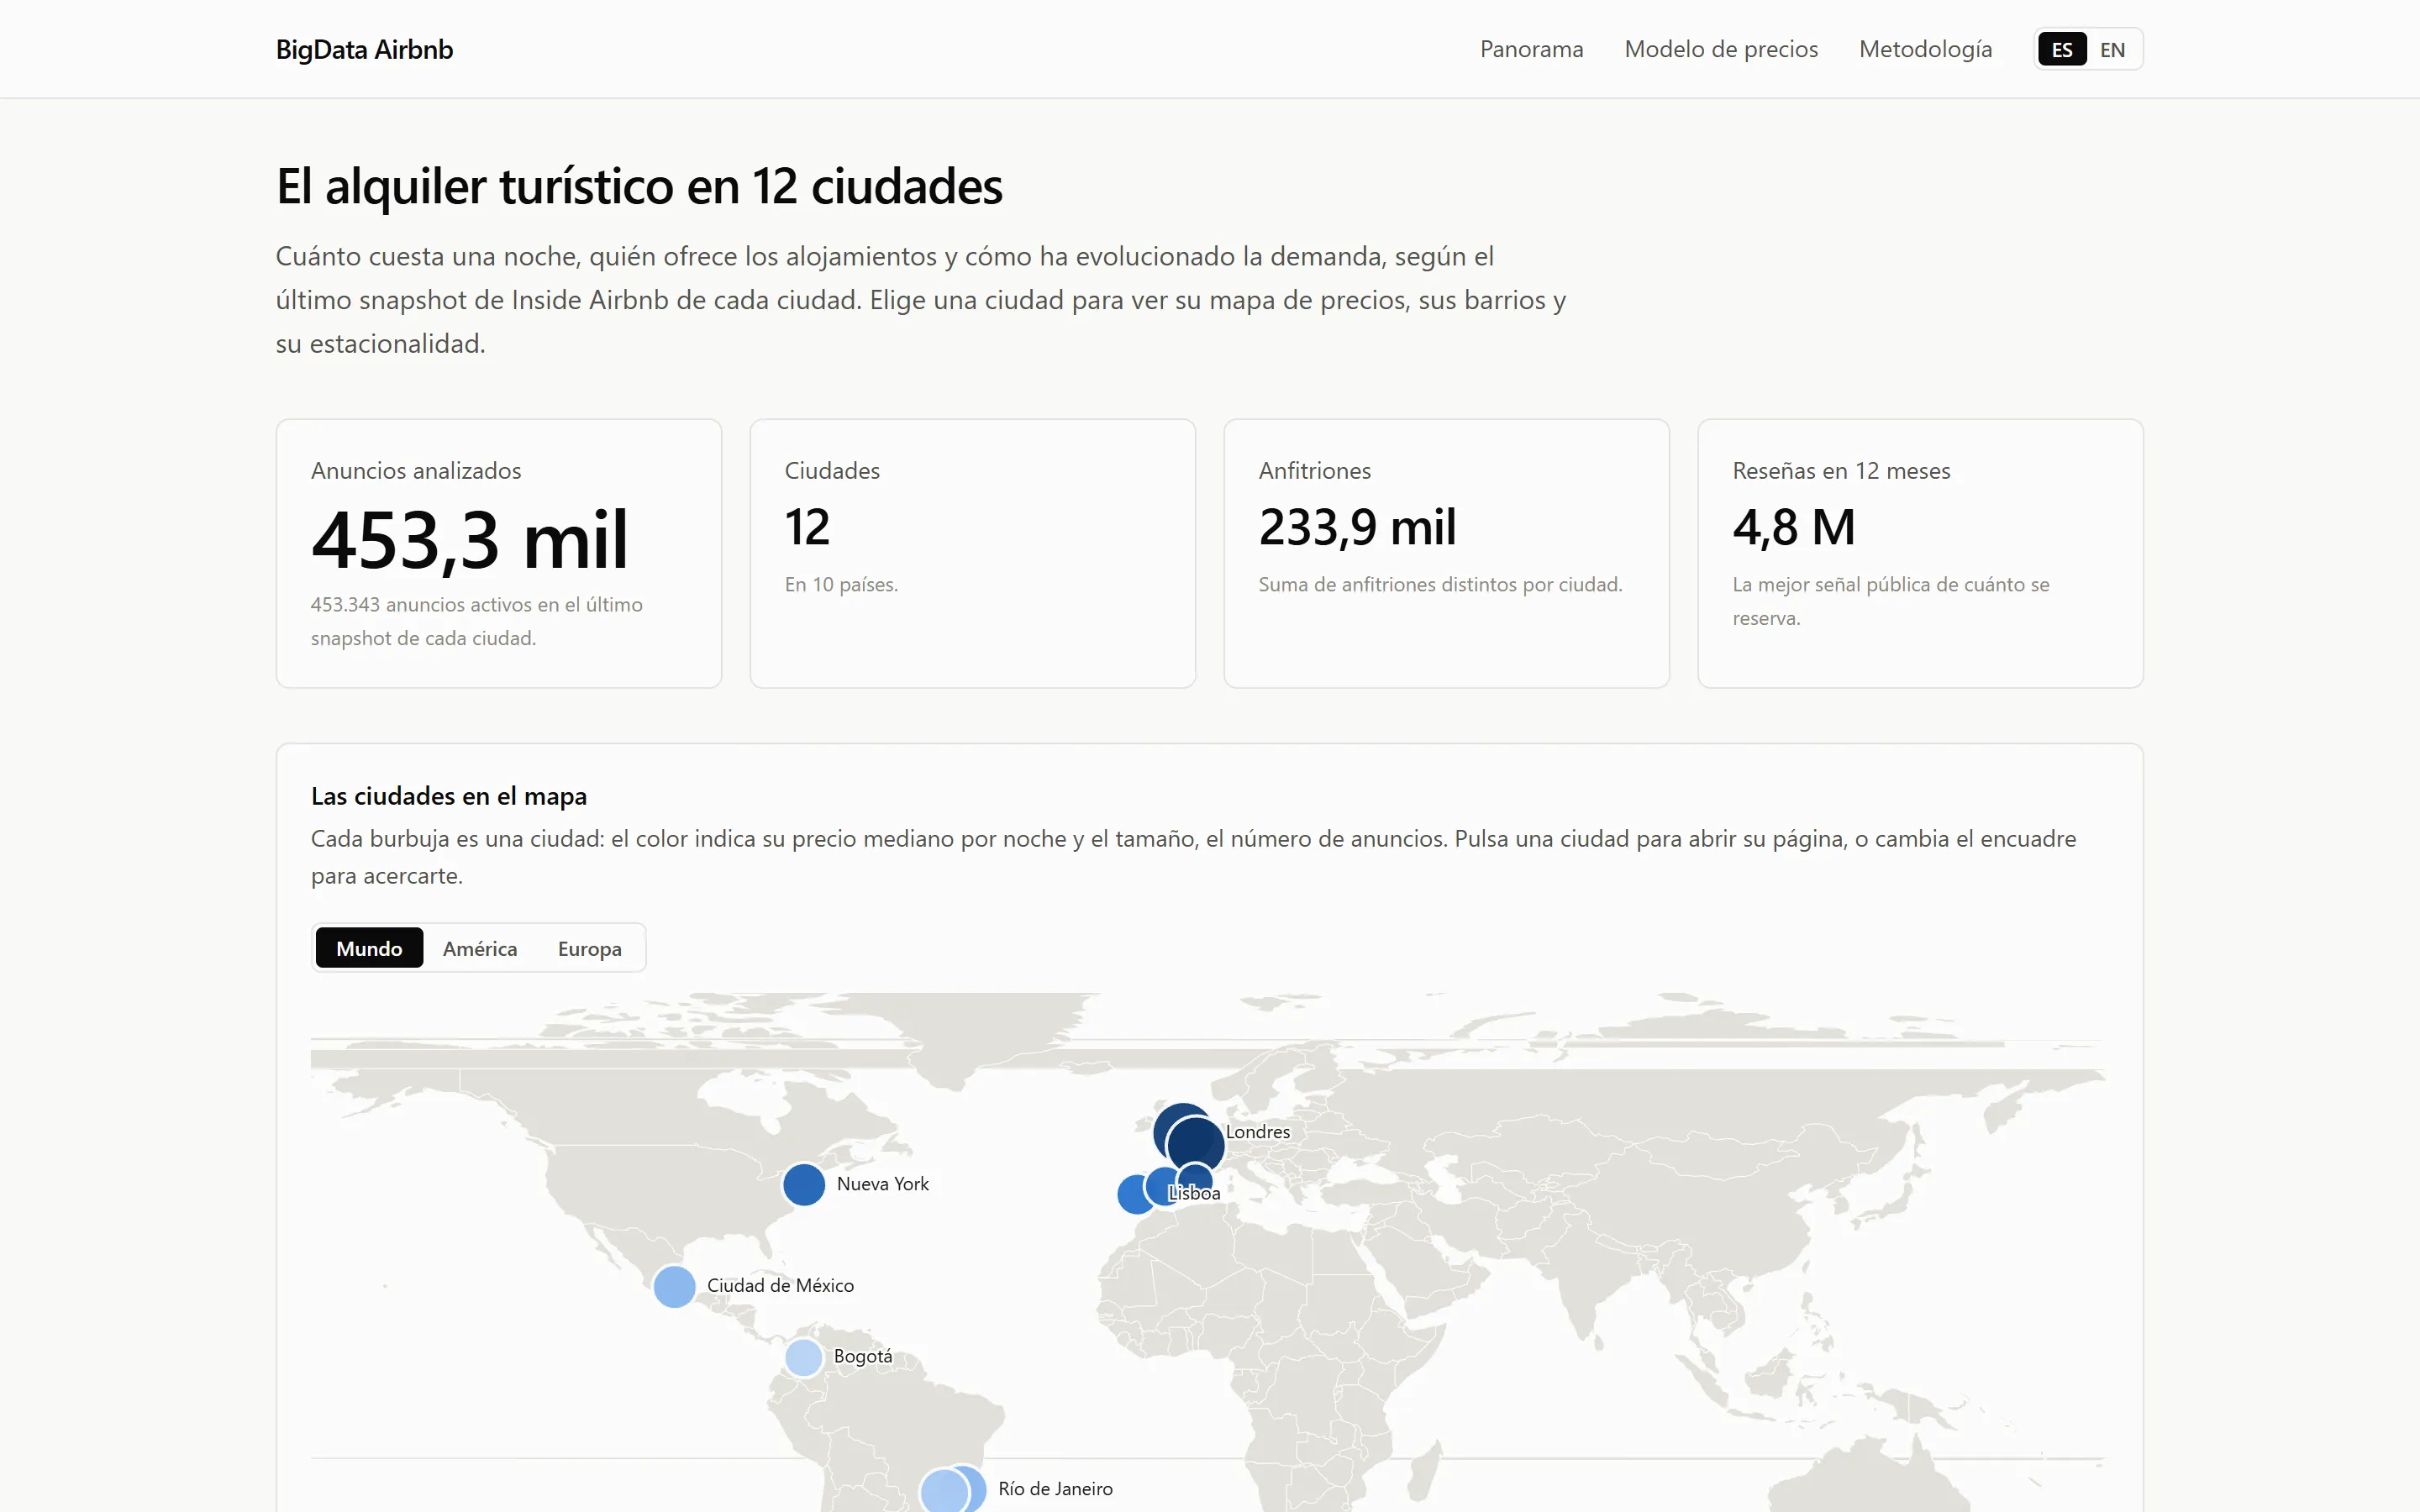
Pipeline batch con Apache Spark sobre HDFS que procesa los datos abiertos de Inside Airbnb de 12 ciudades, entrena un modelo de precios y publica los resultados en un dashboard web.
- Rol
- Proyecto universitario en equipo de cinco en 2025; rediseño completo y autoría individual de la versión actual en 2026
- Periodo
- sept 2025 — nov 2026
- Estado
- Completado
- Tecnologías
- Apache Spark
- HDFS
- Spark ML
- Python
- PostgreSQL
- Next.js
- Docker
El proyecto nació en 2025 como trabajo en equipo del curso de Big Data de la Universidad Privada Antenor Orrego: un pipeline con Kafka y Spark sobre los anuncios de Santiago de Chile. En noviembre de 2026 lo rehíce por completo por mi cuenta. La versión actual descarga los datos abiertos de Inside Airbnb de 12 ciudades, los procesa con Apache Spark sobre HDFS, entrena un modelo de precios y publica los resultados en un dashboard web en español e inglés.
Una ejecución completa lleva 453.343 anuncios, 165,5 millones de filas de calendario y 17,9 millones de reseñas desde los archivos de la fuente hasta el sitio, en unos 16 minutos en un portátil.
Arquitectura
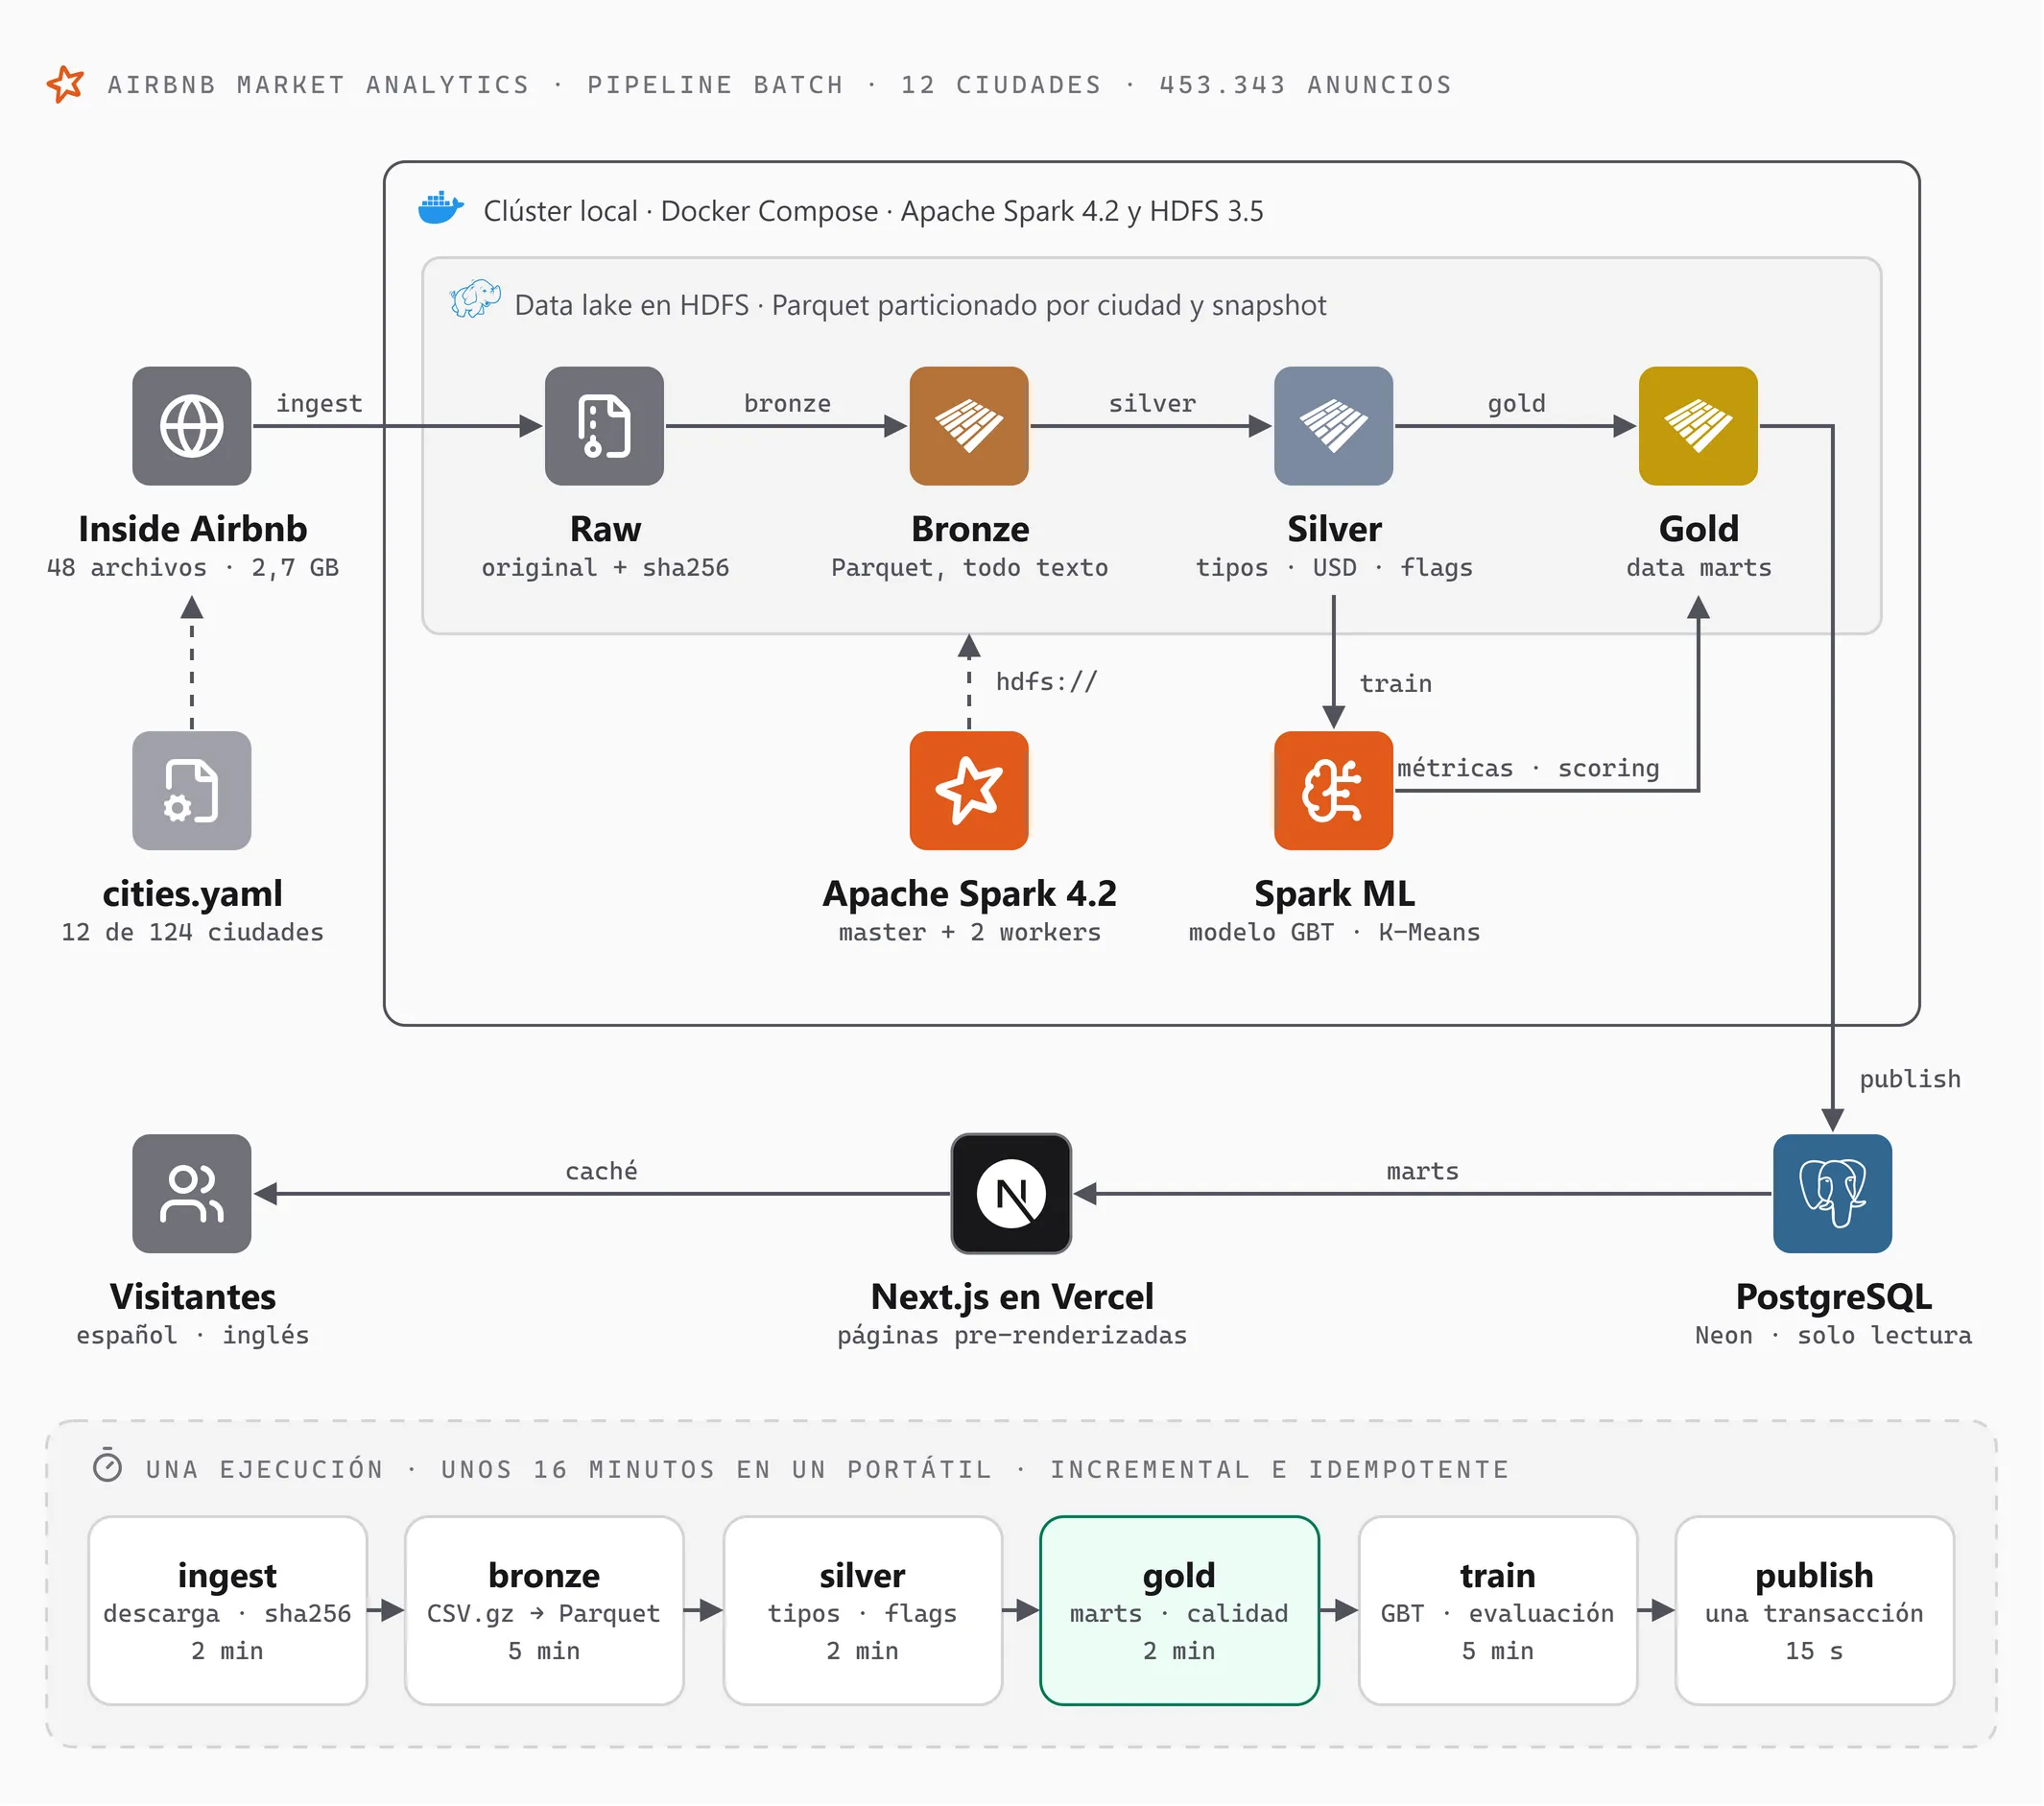
Cada capa del lake tiene una sola responsabilidad:
- Raw. El archivo de la fuente sin tocar, con su tamaño y su sha256. Inside Airbnb solo publica el último snapshot de cada ciudad, así que esta zona es además el archivo histórico.
- Bronze. El mismo contenido en Parquet, con todas las columnas como texto. Solo cambia el formato, y cada archivo se ajusta a un contrato de columnas: un cambio de esquema en la fuente no desplaza datos.
- Silver. Tablas con tipos, precios convertidos a dólares, sin duplicados y con flags de calidad.
- Gold. Agregados pequeños, uno por cada pregunta del dashboard. El sitio nunca toca datos en bruto.
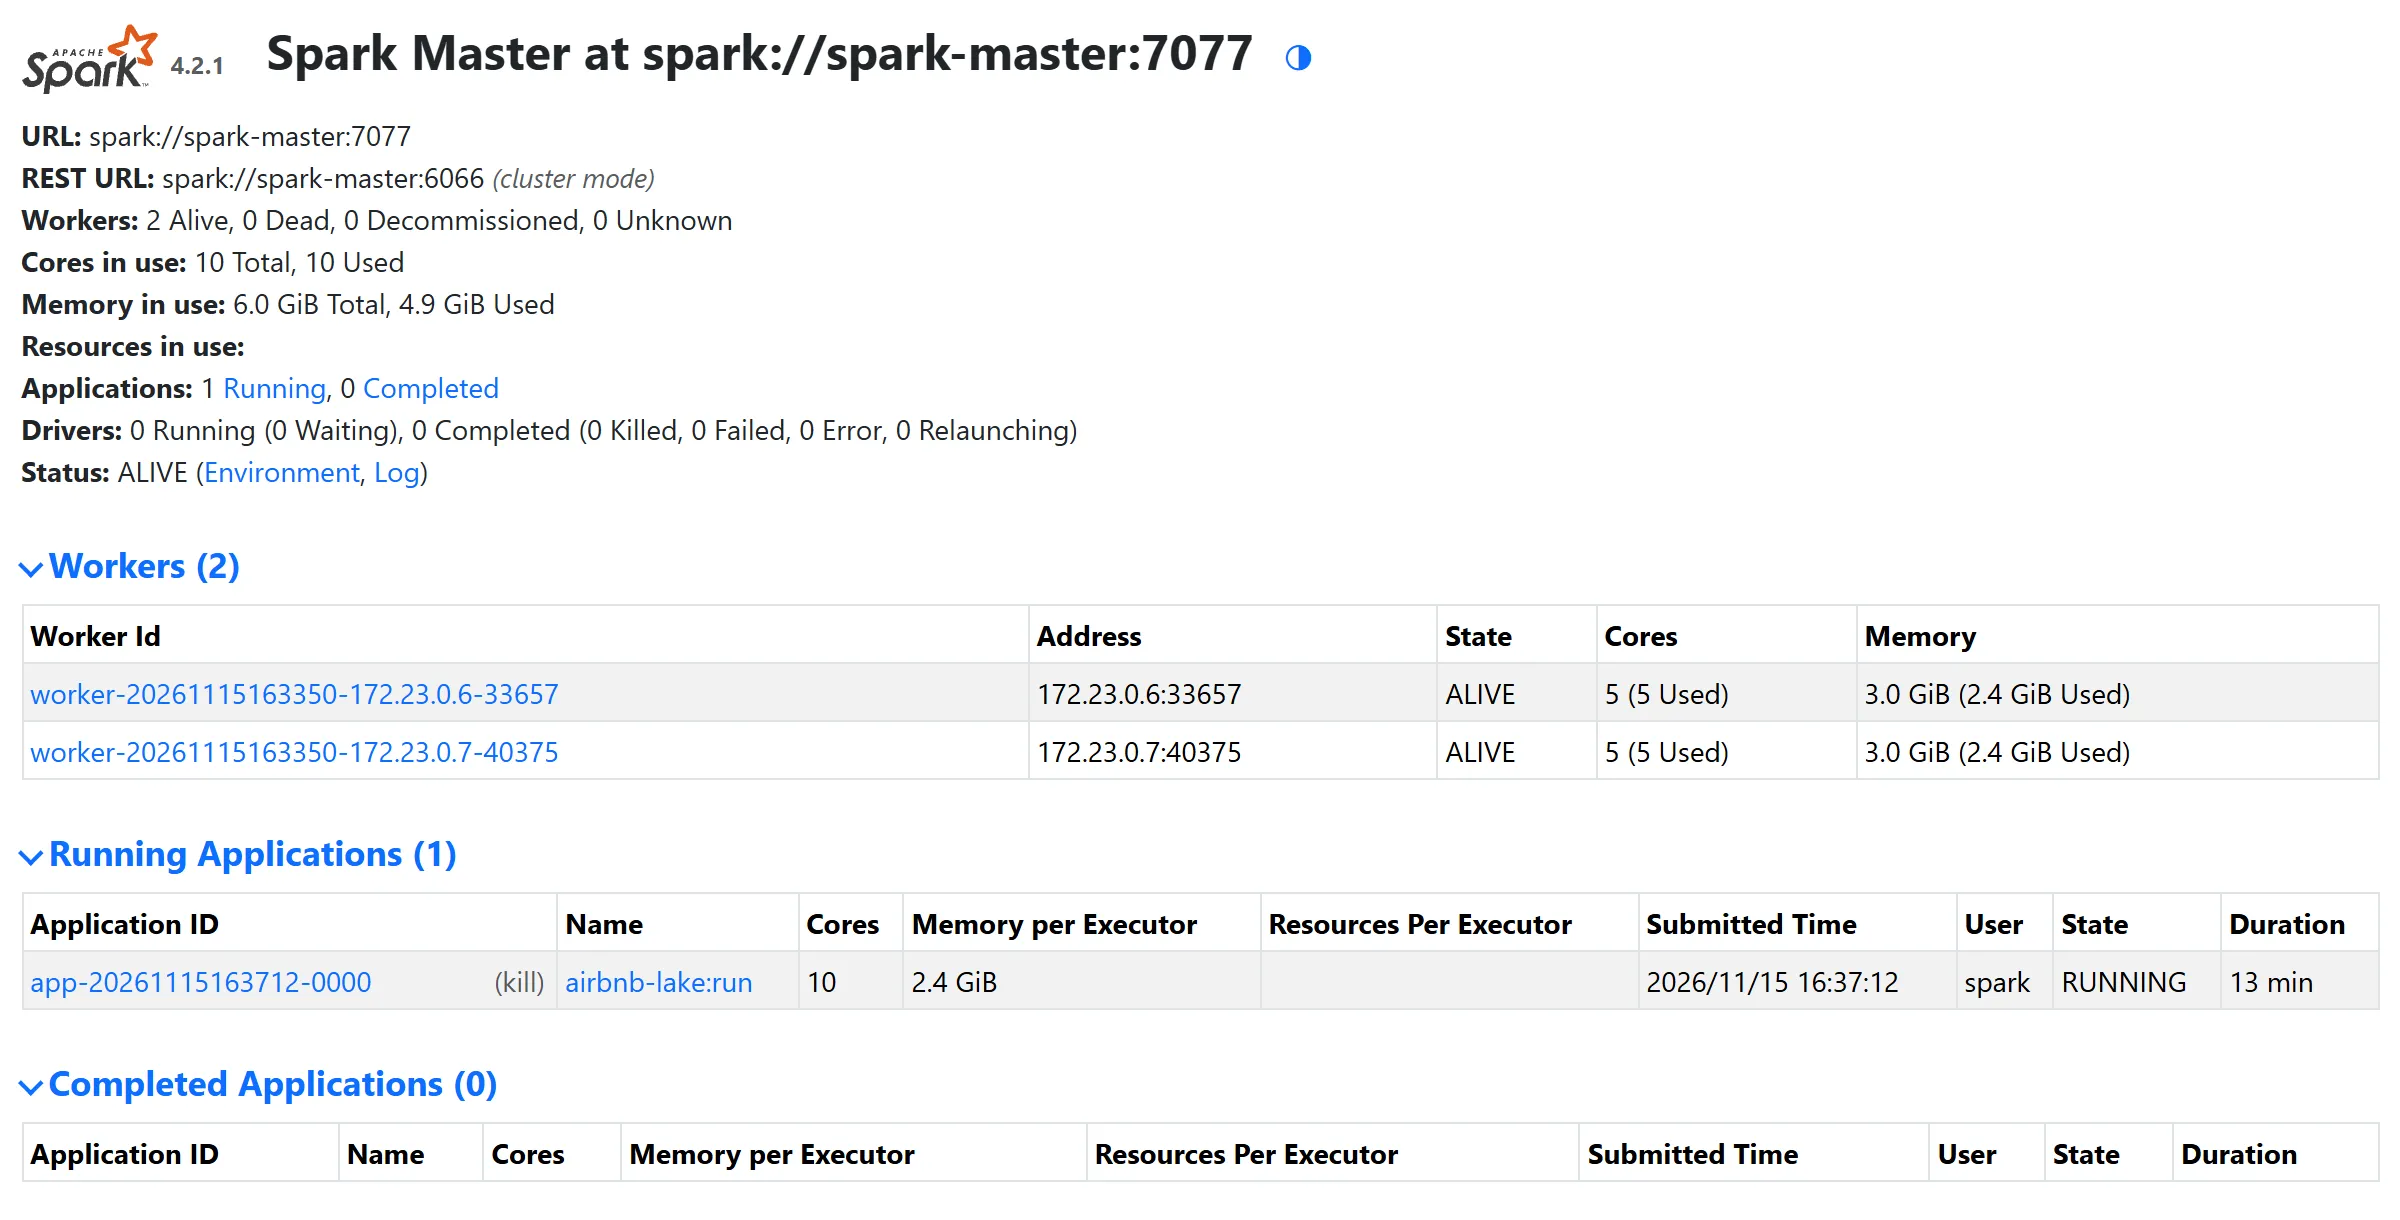
Todo corre en un clúster local definido con Docker Compose: HDFS, Spark en modo standalone con un master y dos workers, y una base PostgreSQL que replica el esquema de producción. La raíz del lake es una URI de Hadoop, así que el mismo código funciona sobre hdfs://, s3a:// o abfss://.
Decisiones de ingeniería
- Incremental e idempotente. Cada etapa procesa solo las particiones de ciudad y snapshot que faltan, y relanzarla no duplica nada. Cuando la fuente publica un snapshot nuevo, se guarda junto a los anteriores y los marts pasan a reflejar el más reciente.
- El CSV se lee conforme al RFC 4180. El archivo de Santiago tiene 18.904 registros en 32.585 líneas, porque hay saltos de línea dentro de los campos. La versión original lo leía línea a línea y las columnas se desplazaban. Ahora hay un test de regresión para ese caso.
- Las filas dudosas se etiquetan, no se borran. Un precio atípico, unas coordenadas fuera de la ciudad o un tipo de alojamiento inválido quedan como flags en Silver, y cada consumidor decide qué filtrar.
- Validaciones que detienen la publicación. Anuncios duplicados, tipos de alojamiento inválidos, ciudades sin datos o fechas de calendario repetidas paran el pipeline antes de que nada llegue al sitio.
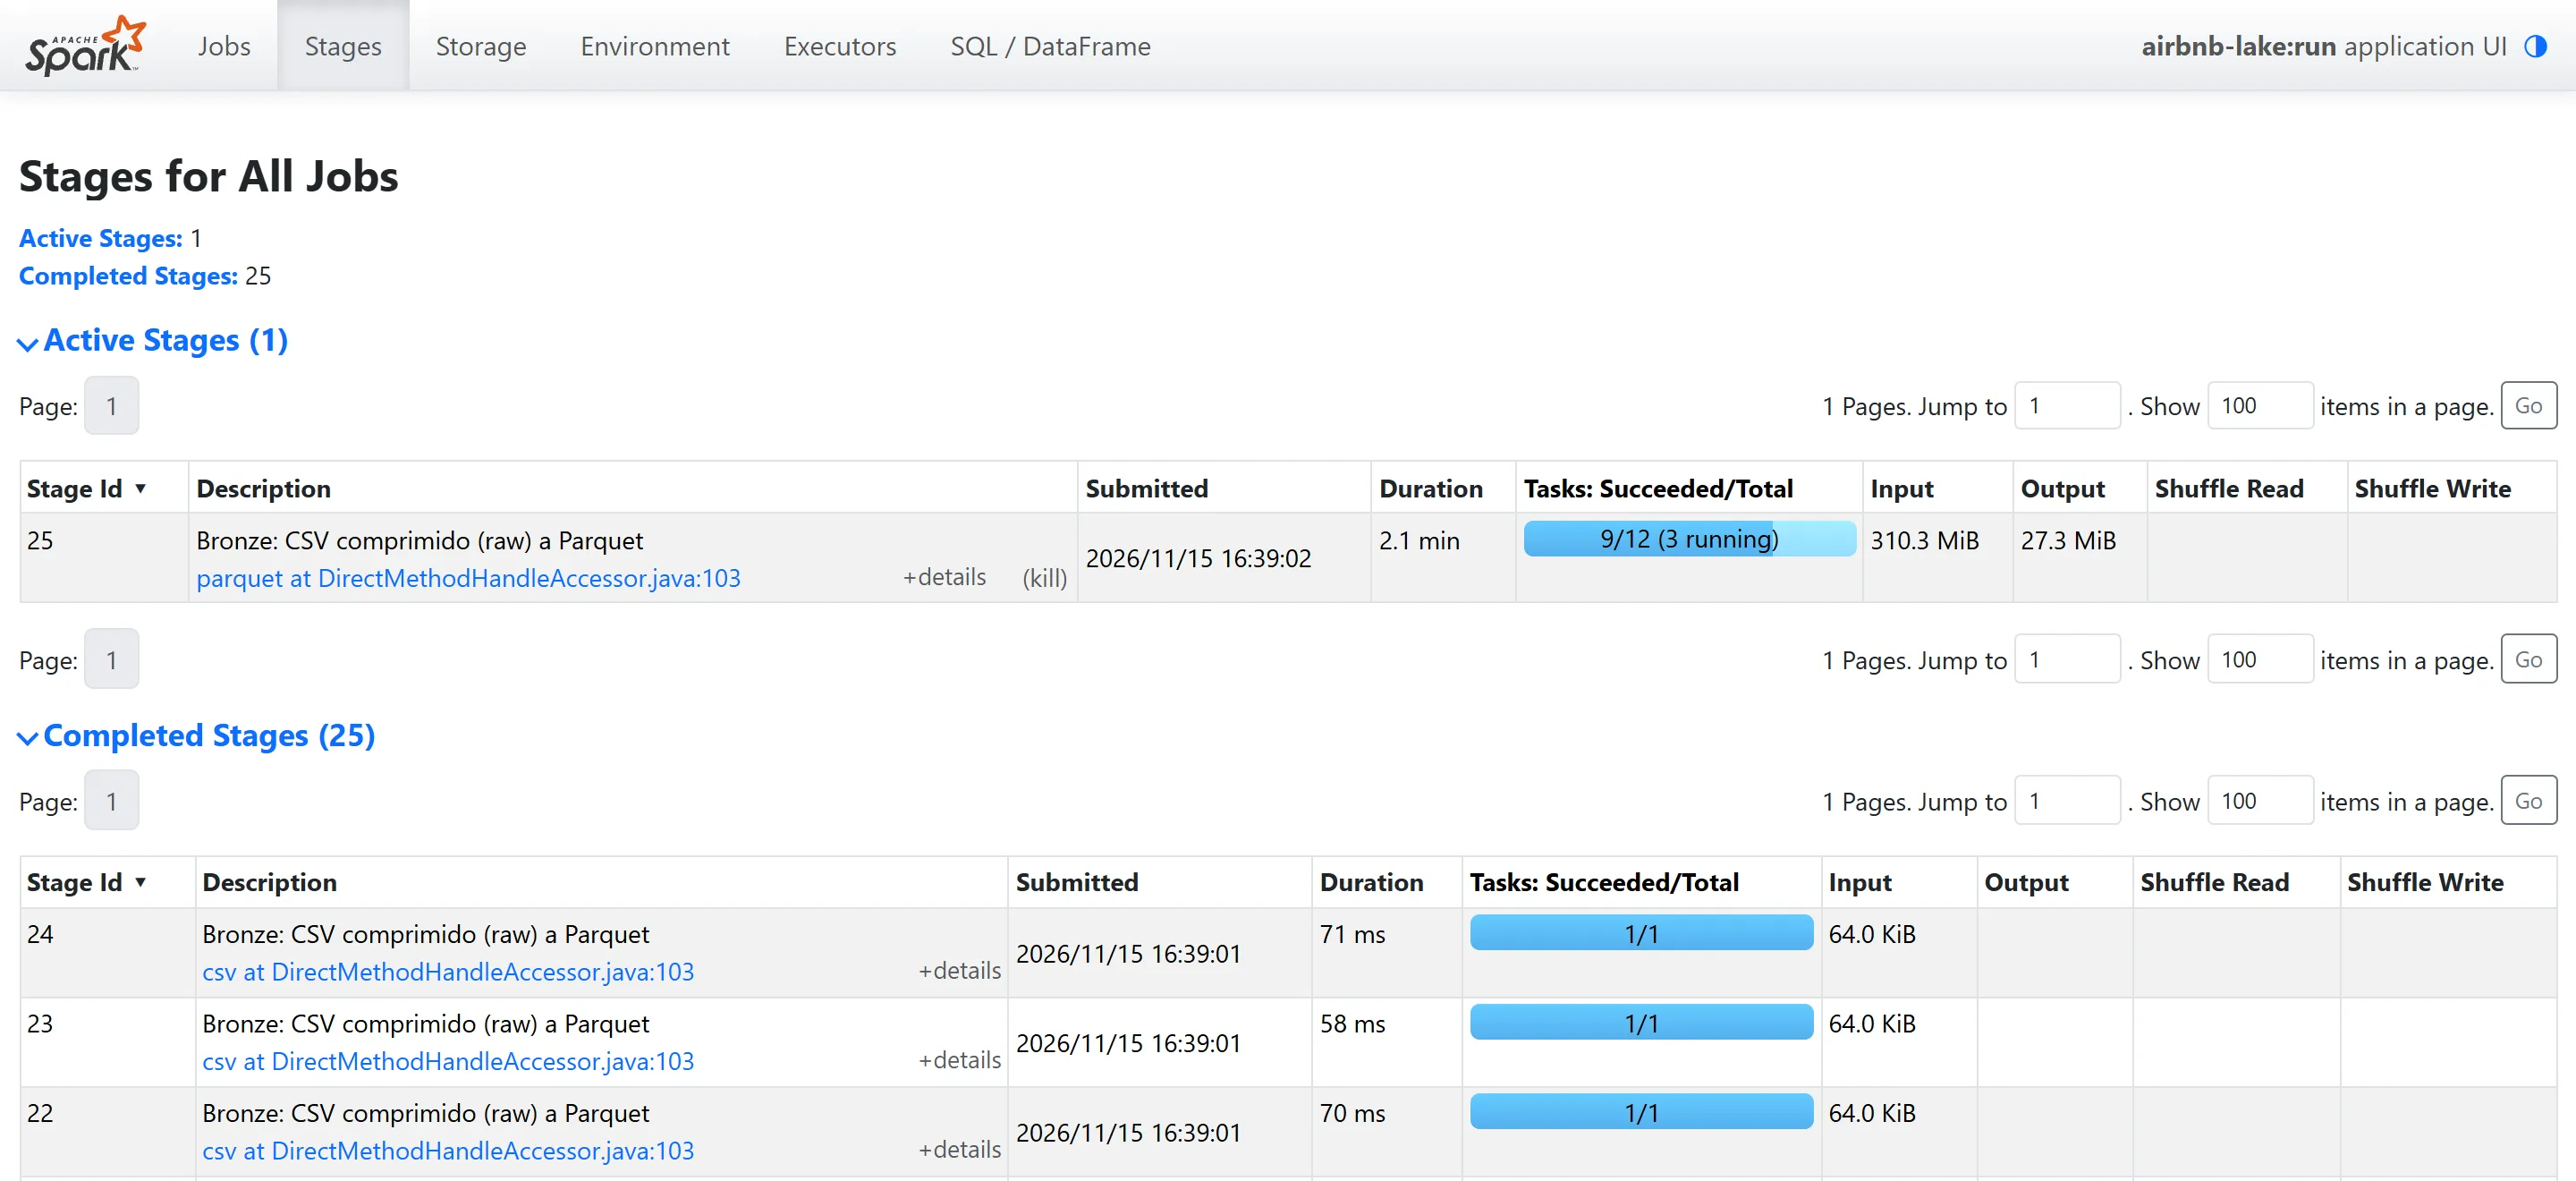
- Rendimiento sin UDF de Python. Todas las transformaciones son expresiones nativas de Spark. El calendario se reduce a anuncio por mes al pasar a Silver, antes de cualquier join, y Bronze une los archivos comprimidos, que no son divisibles, en un único plan para procesarlos en paralelo.
- Una ciudad nueva es una entrada de configuración. El catálogo de la fuente tiene 124 ciudades; añadir una al archivo
cities.yamly volver a ejecutar procesa solo esa ciudad.
El pipeline en ejecución
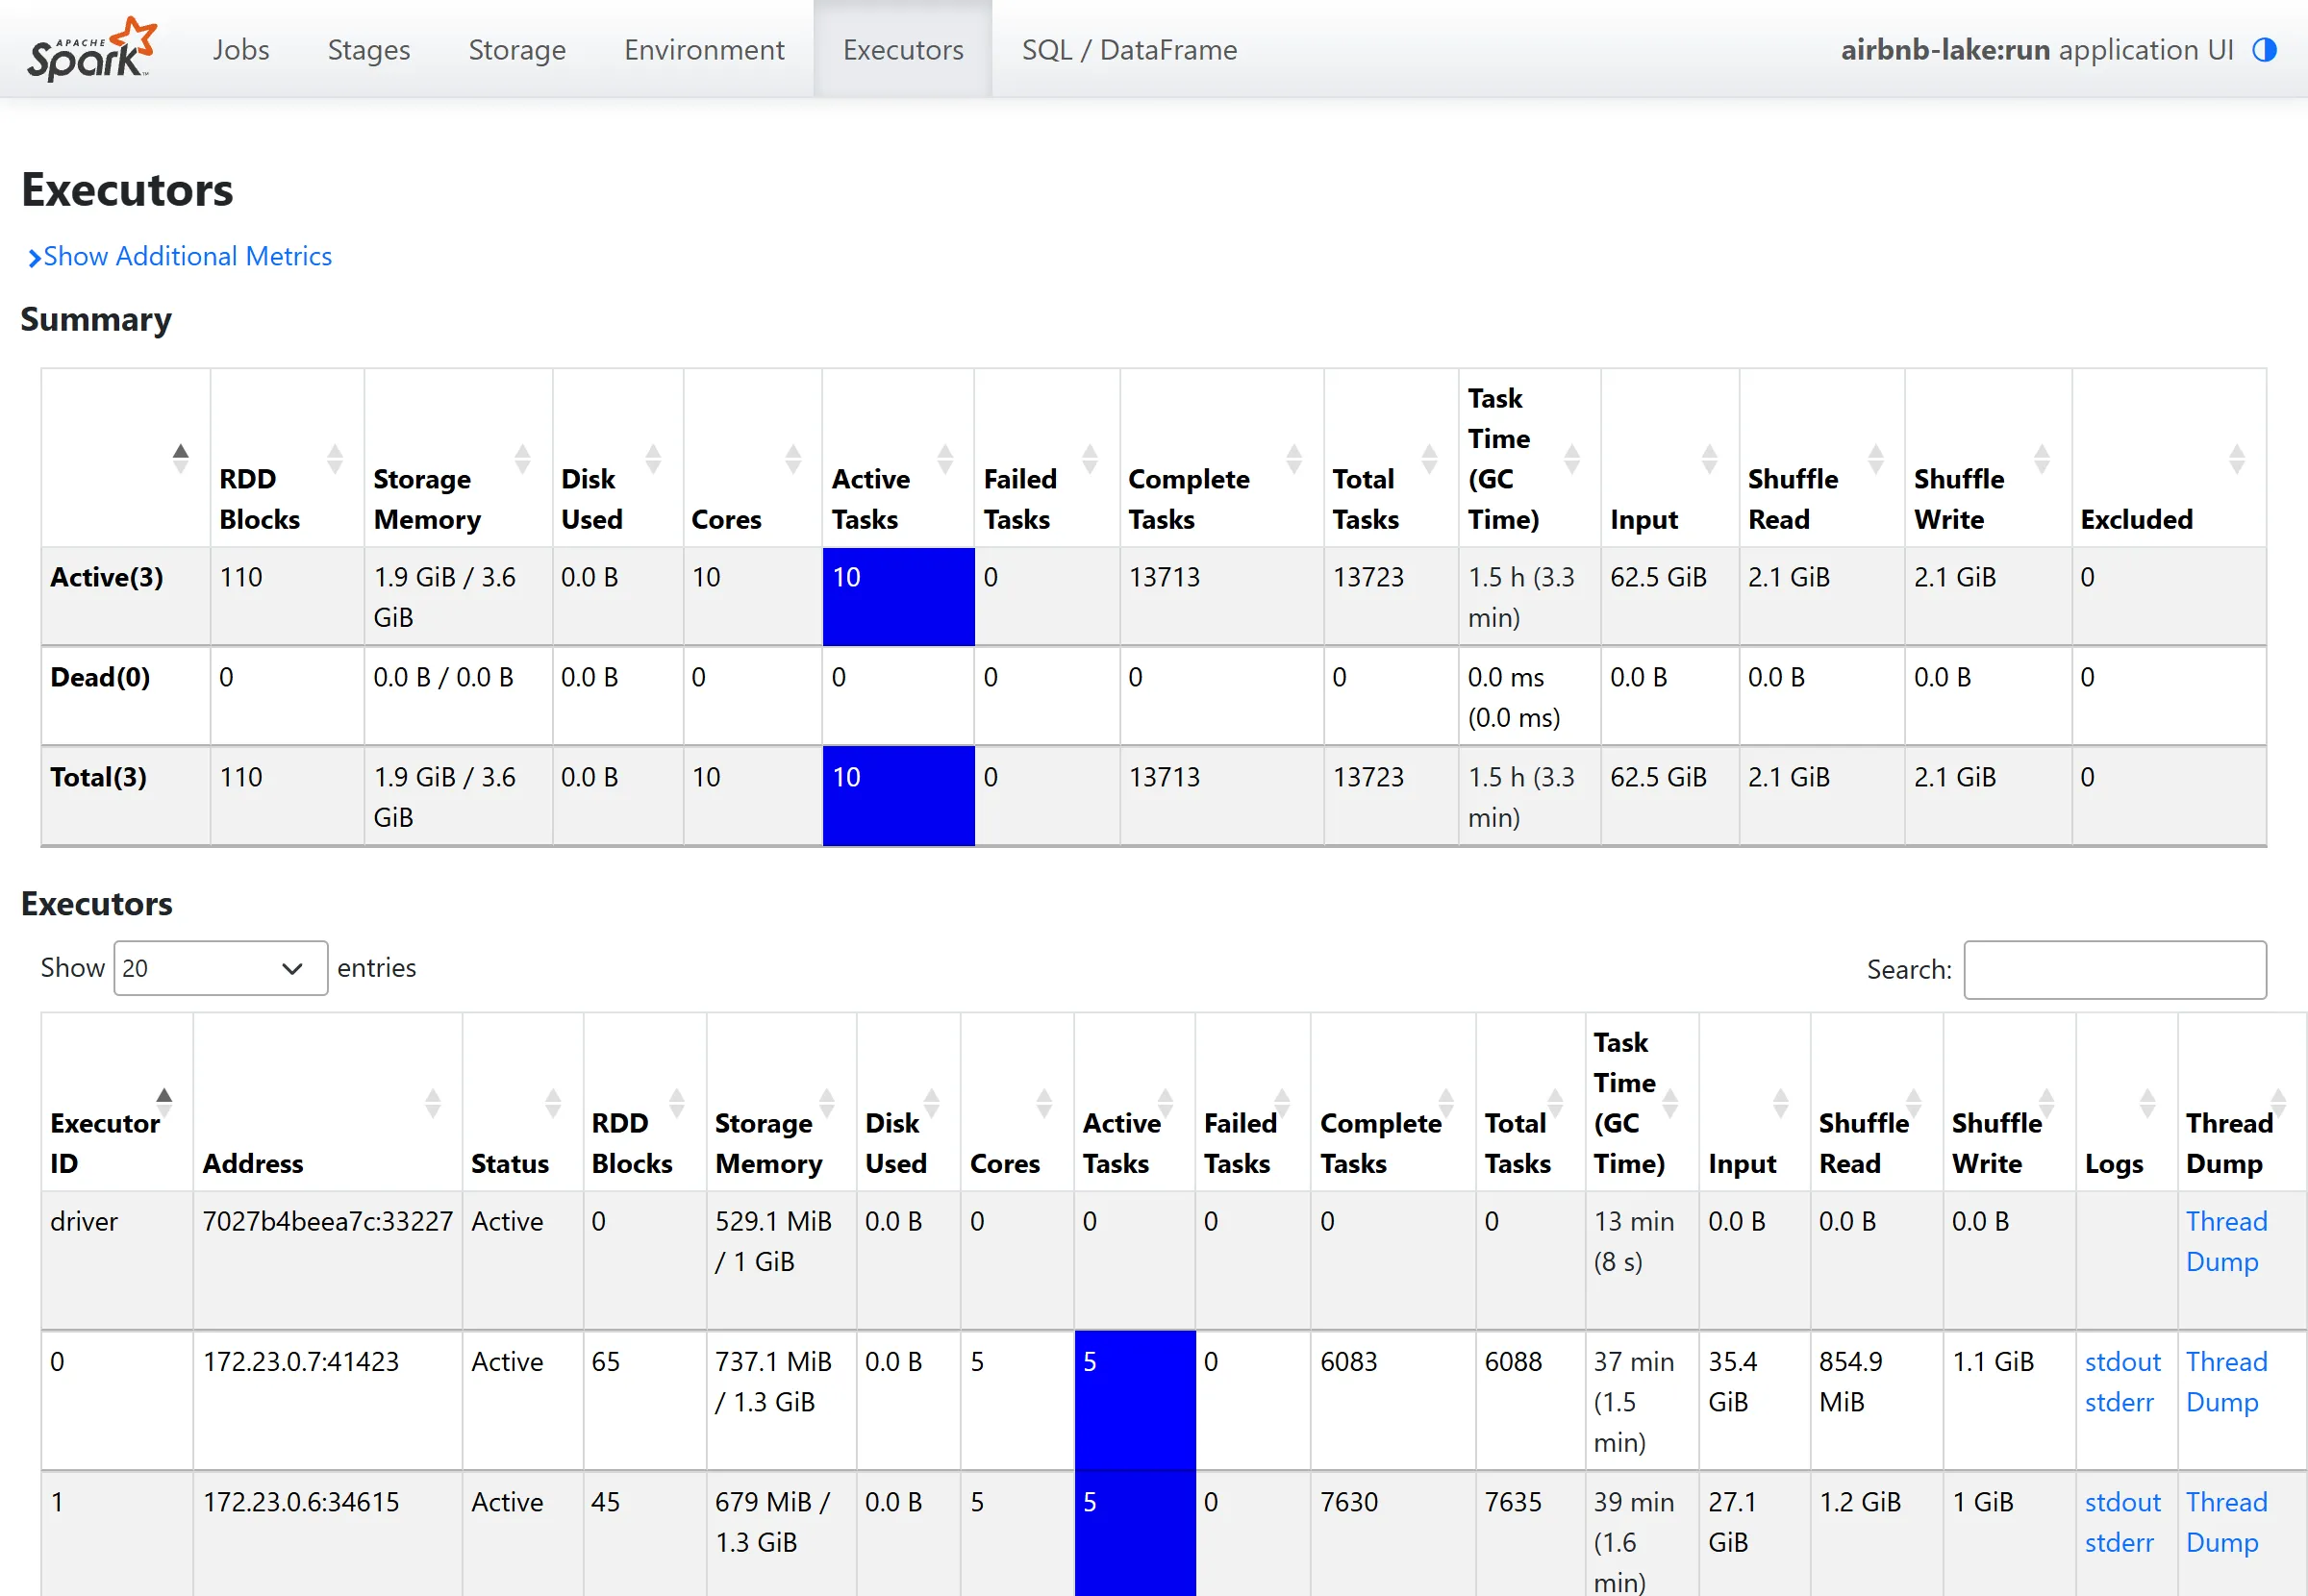
Lo que sigue es el registro de una ejecución completa sobre el clúster local, del 15 de noviembre de 2026. El maestro de Spark, con sus dos workers y los diez núcleos ocupados por la aplicación:
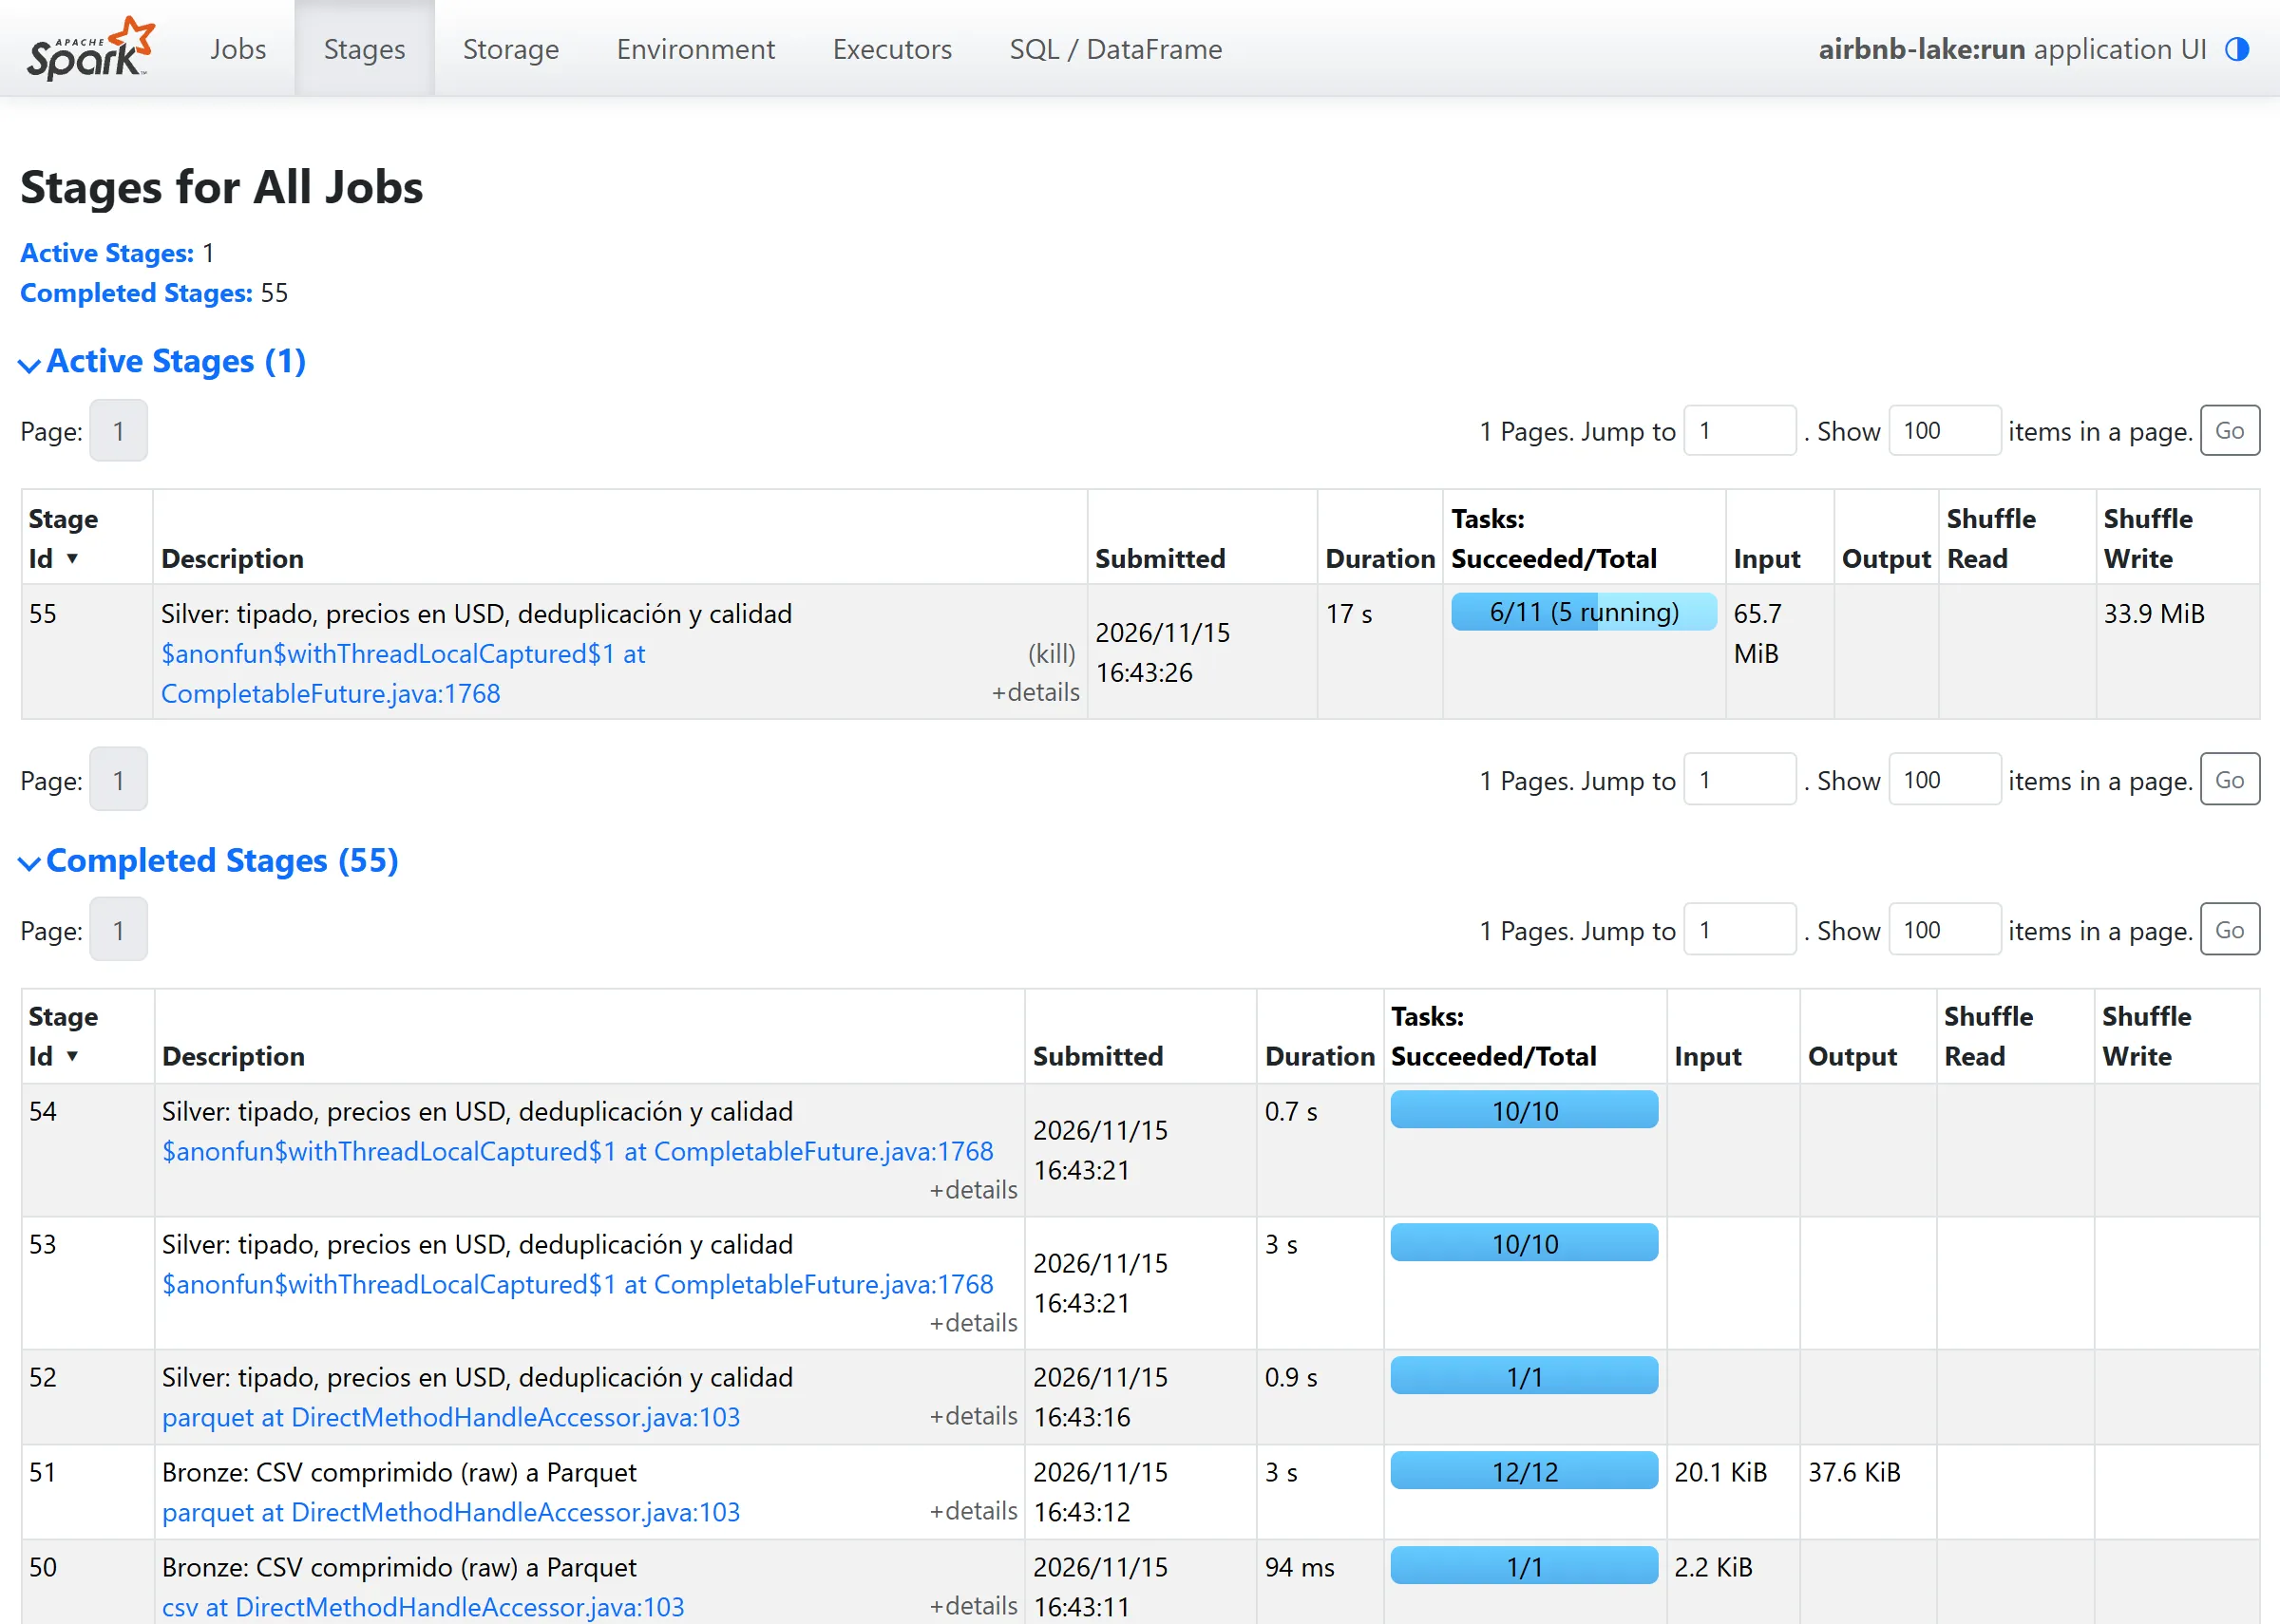
En bronze, cada archivo comprimido de la fuente es una tarea, y las tareas se reparten entre los dos ejecutores:
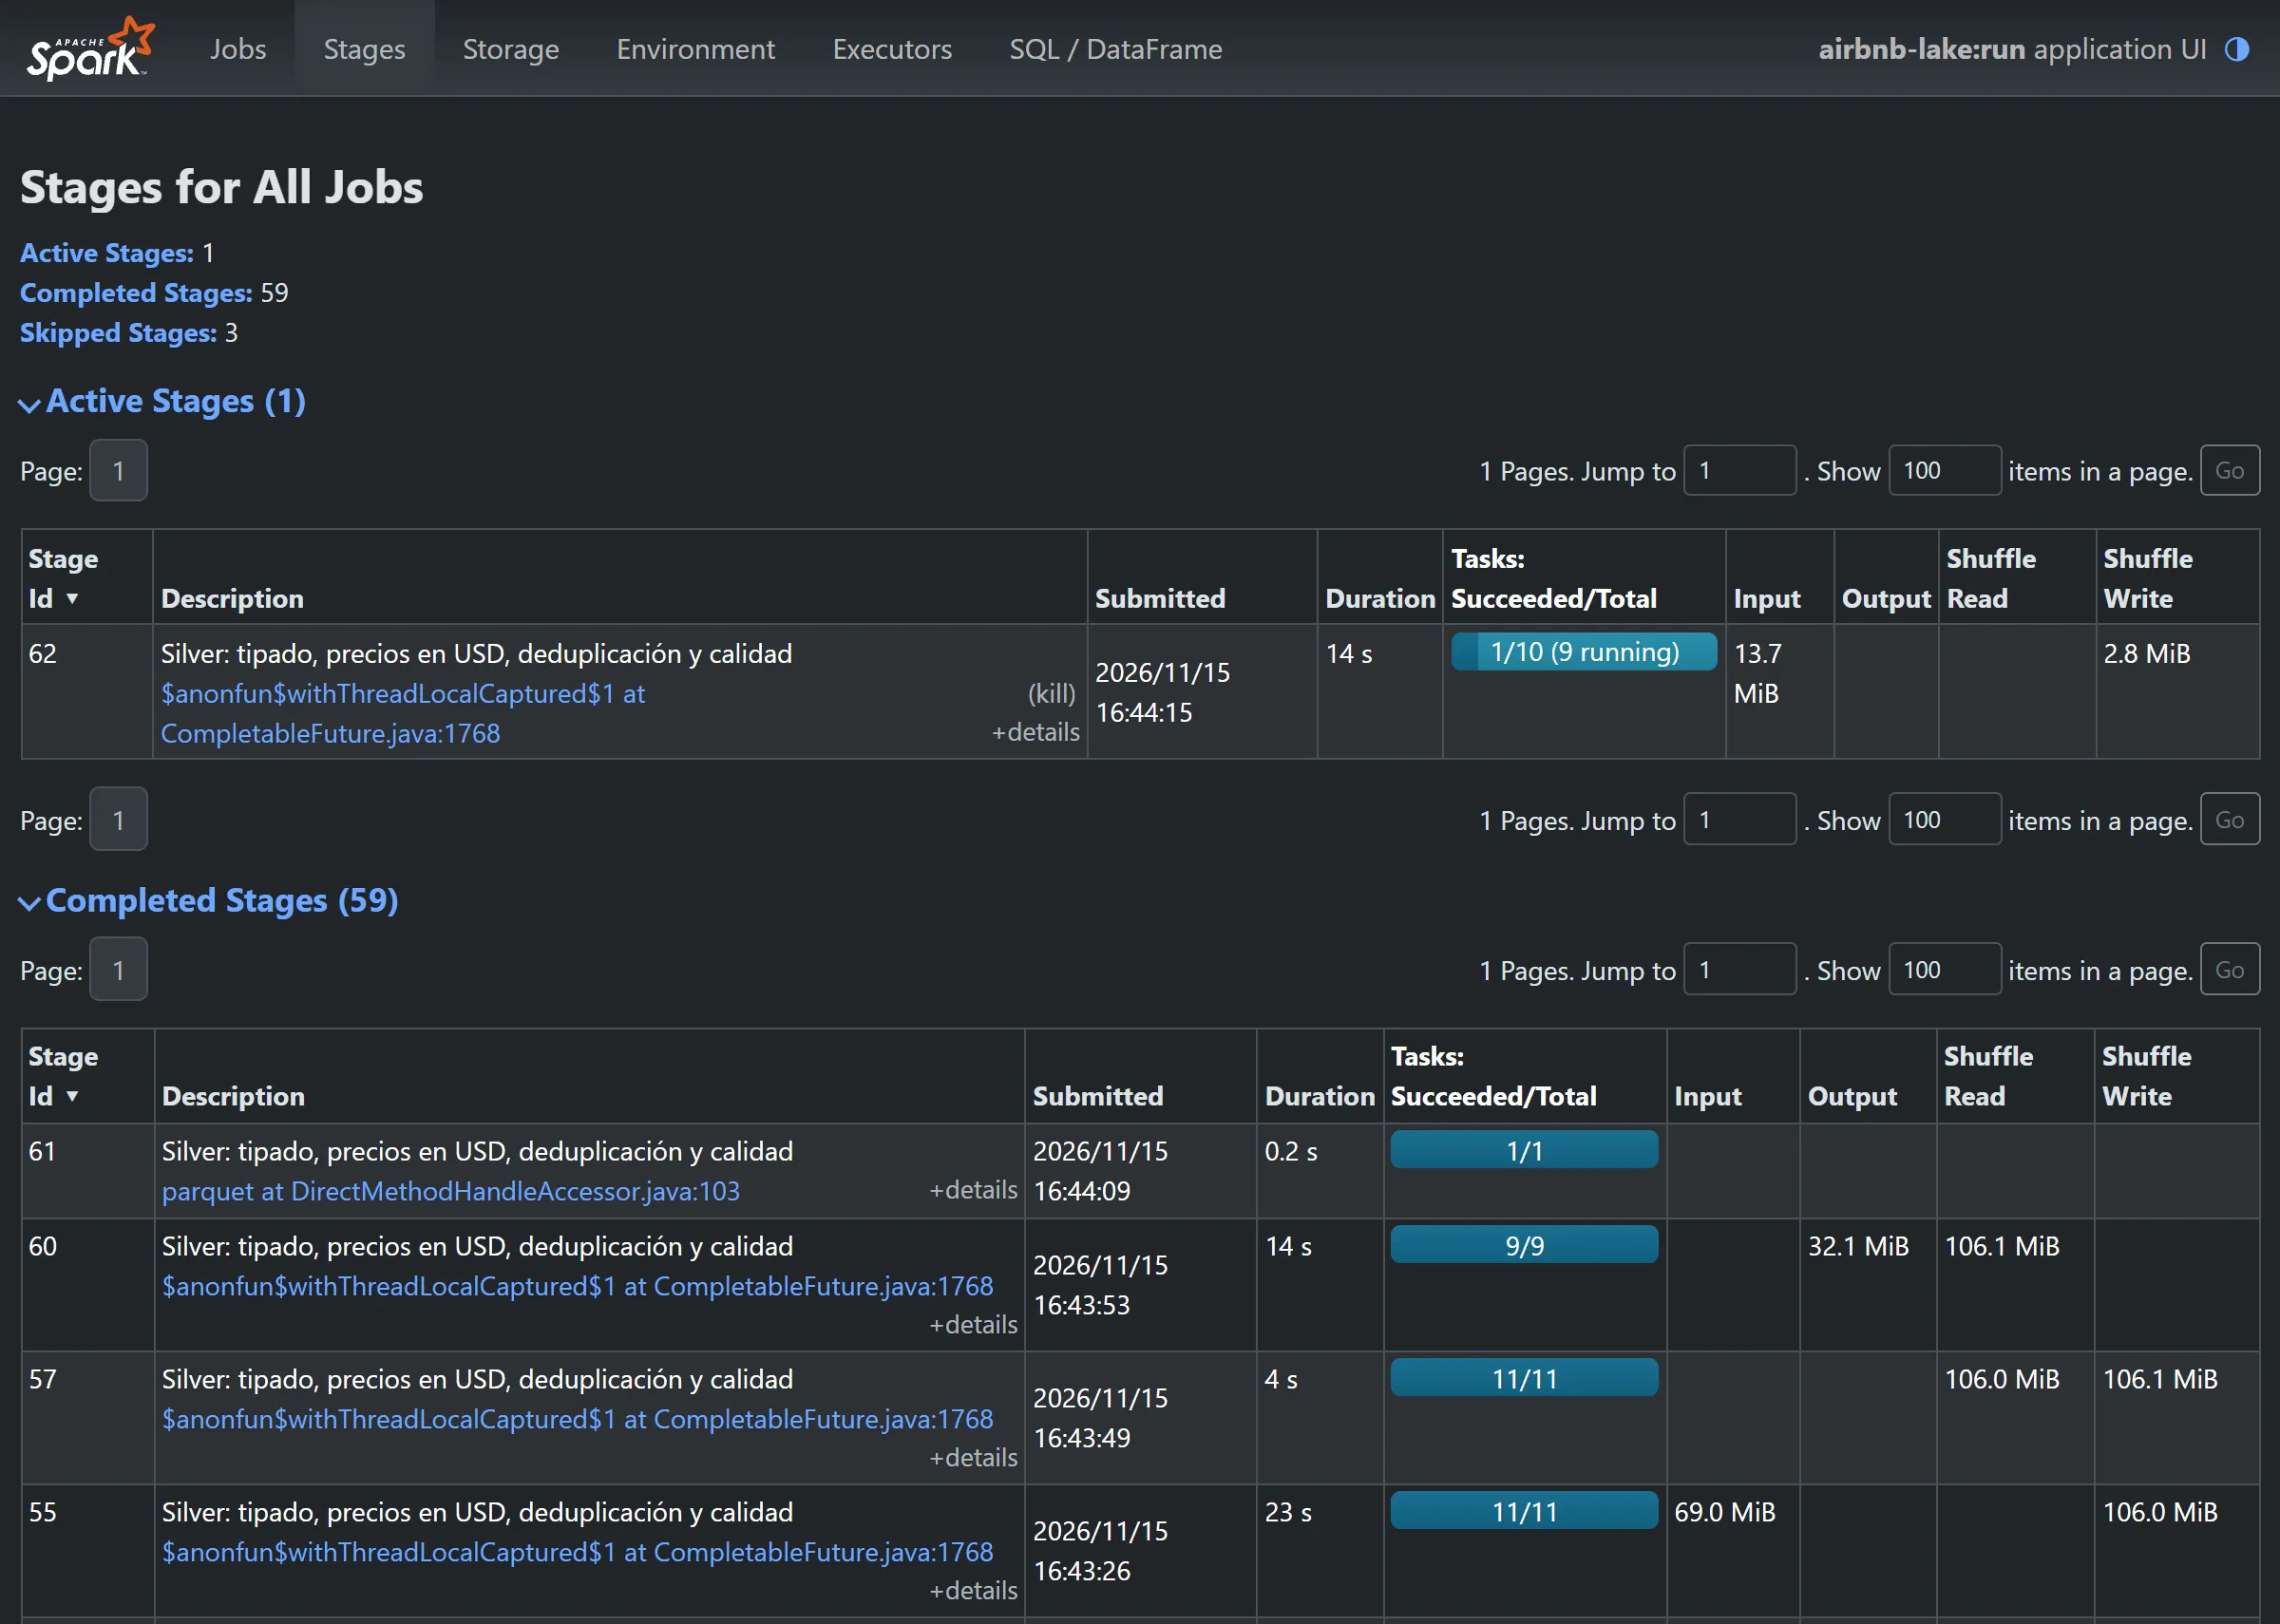
En silver aparecen los shuffles de la deduplicación, con sus columnas de lectura y escritura:
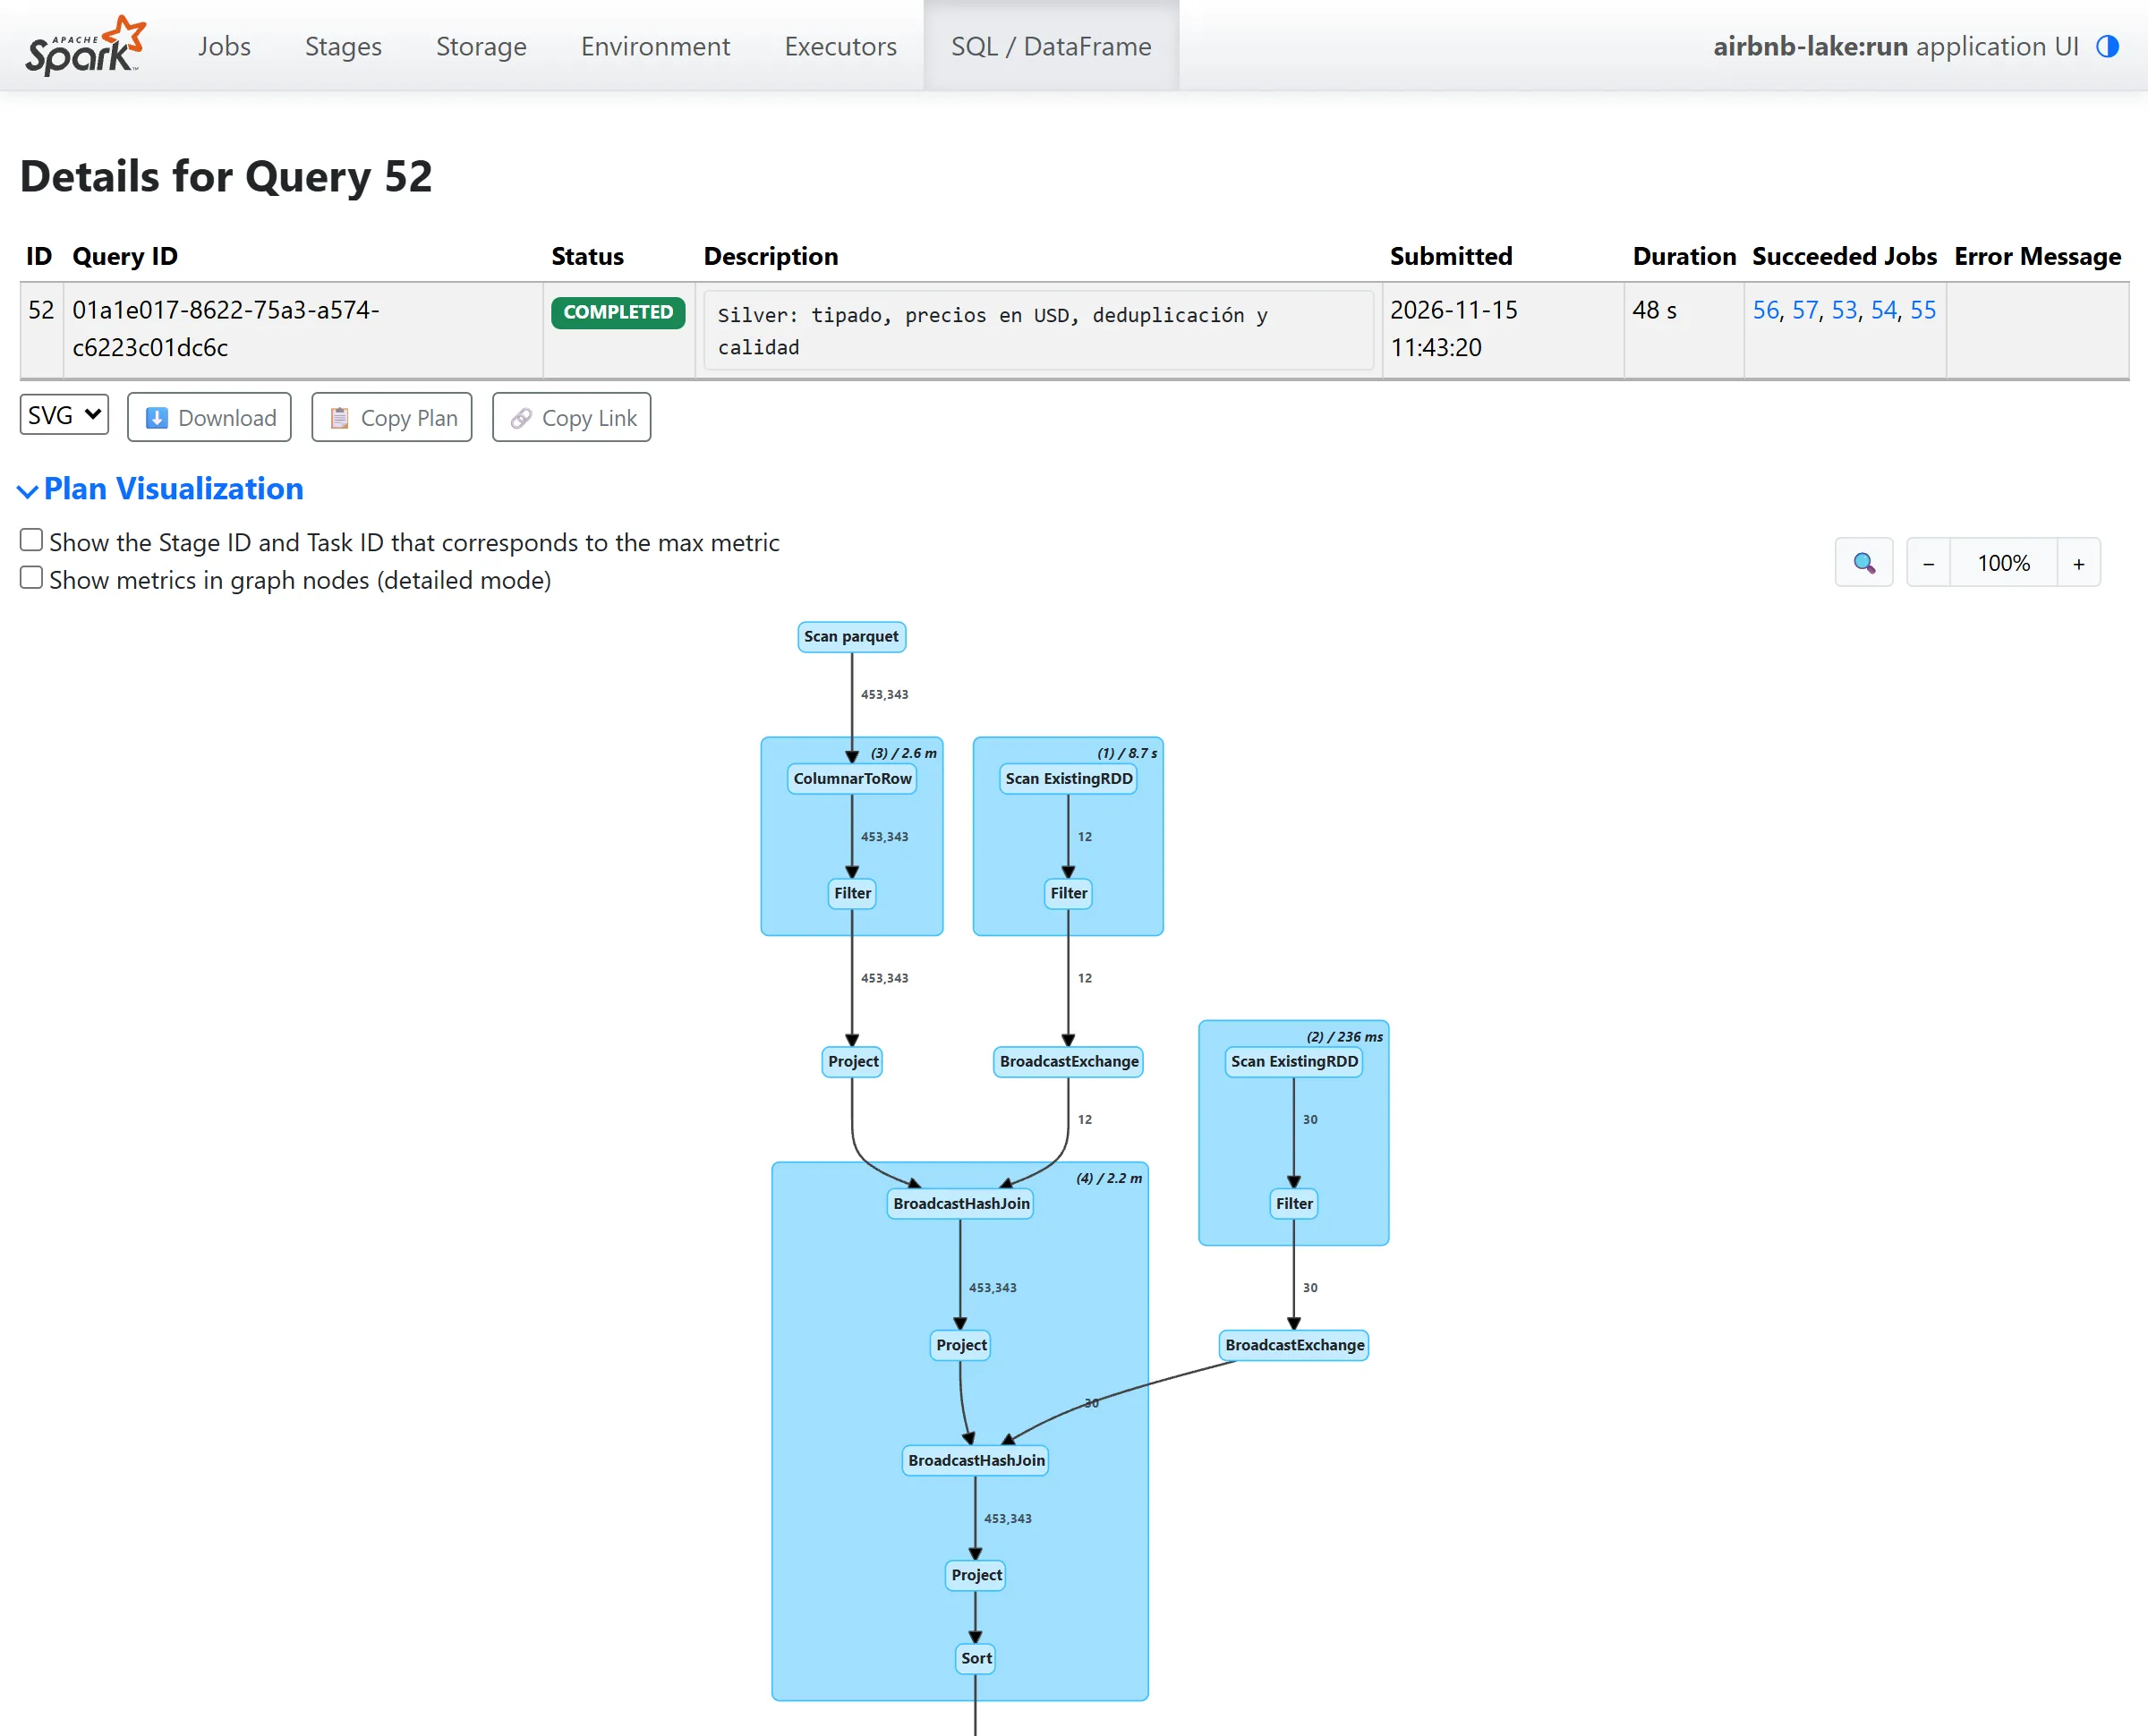
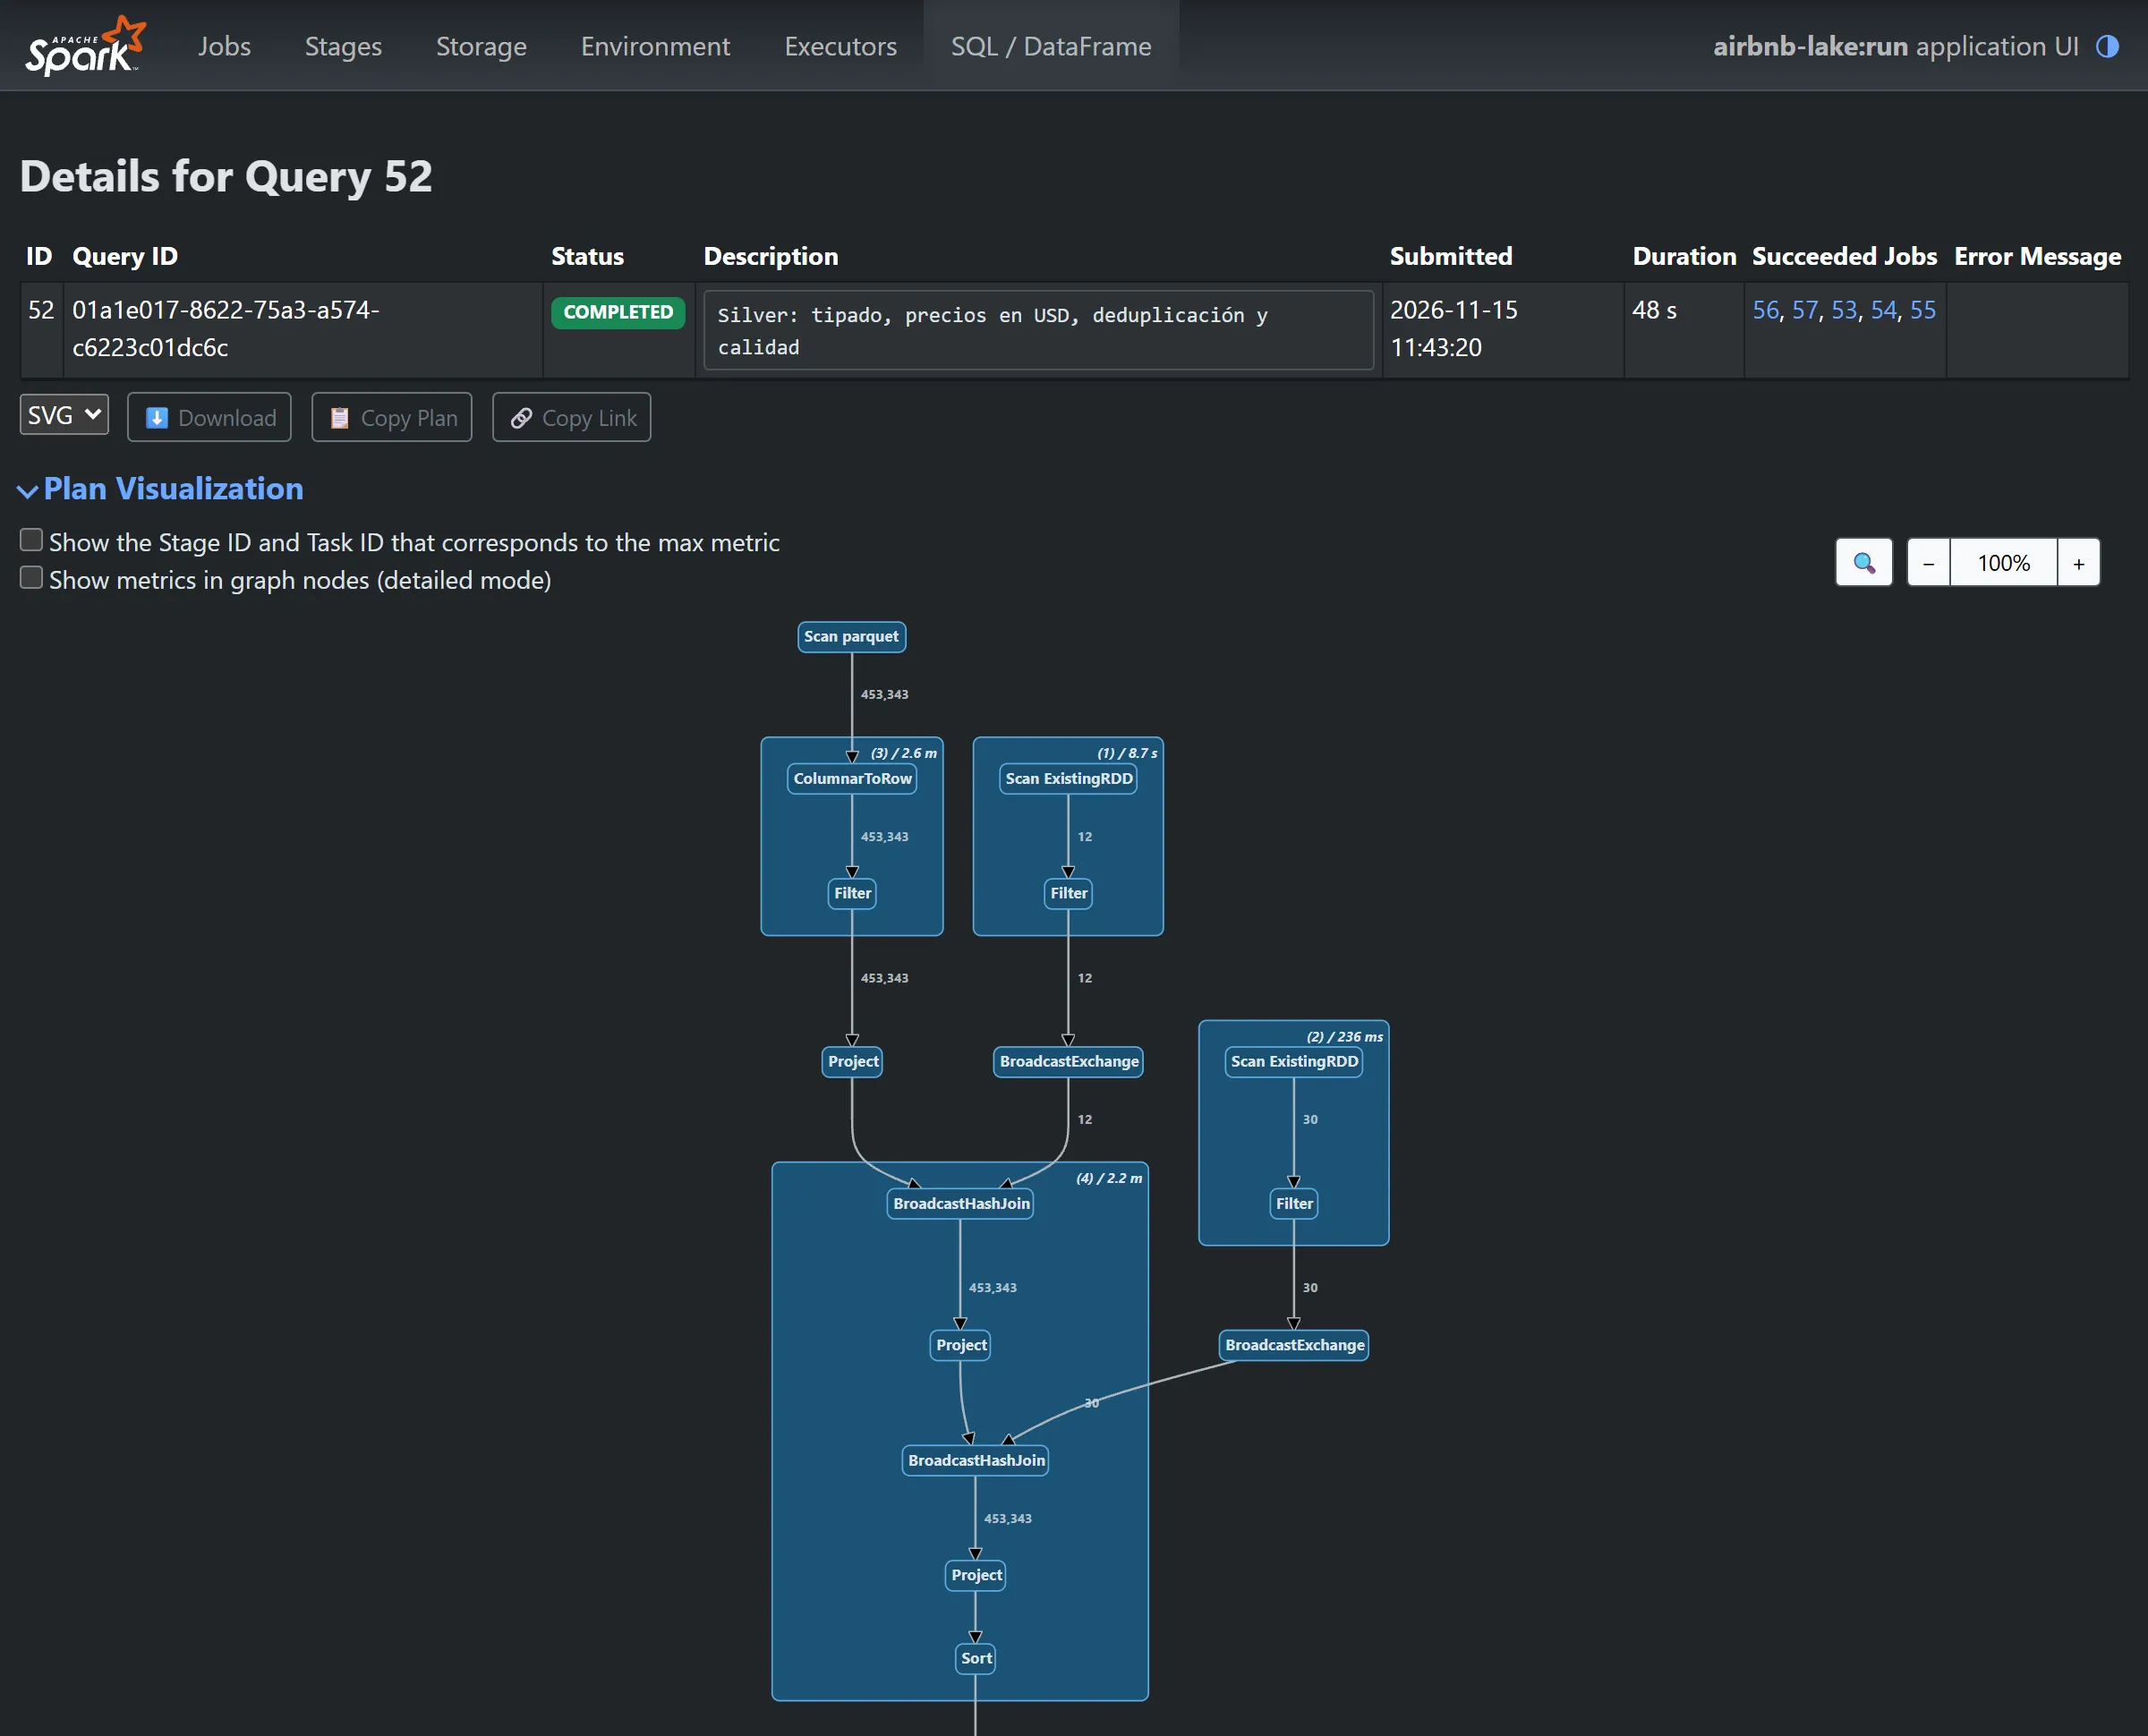
El plan de la consulta de anuncios empieza con la lectura de Bronze y dos joins por difusión contra dos tablas pequeñas, la de ciudades y la de tipos de cambio. Más abajo, fuera de la captura, siguen las ventanas que eliminan duplicados y la escritura:
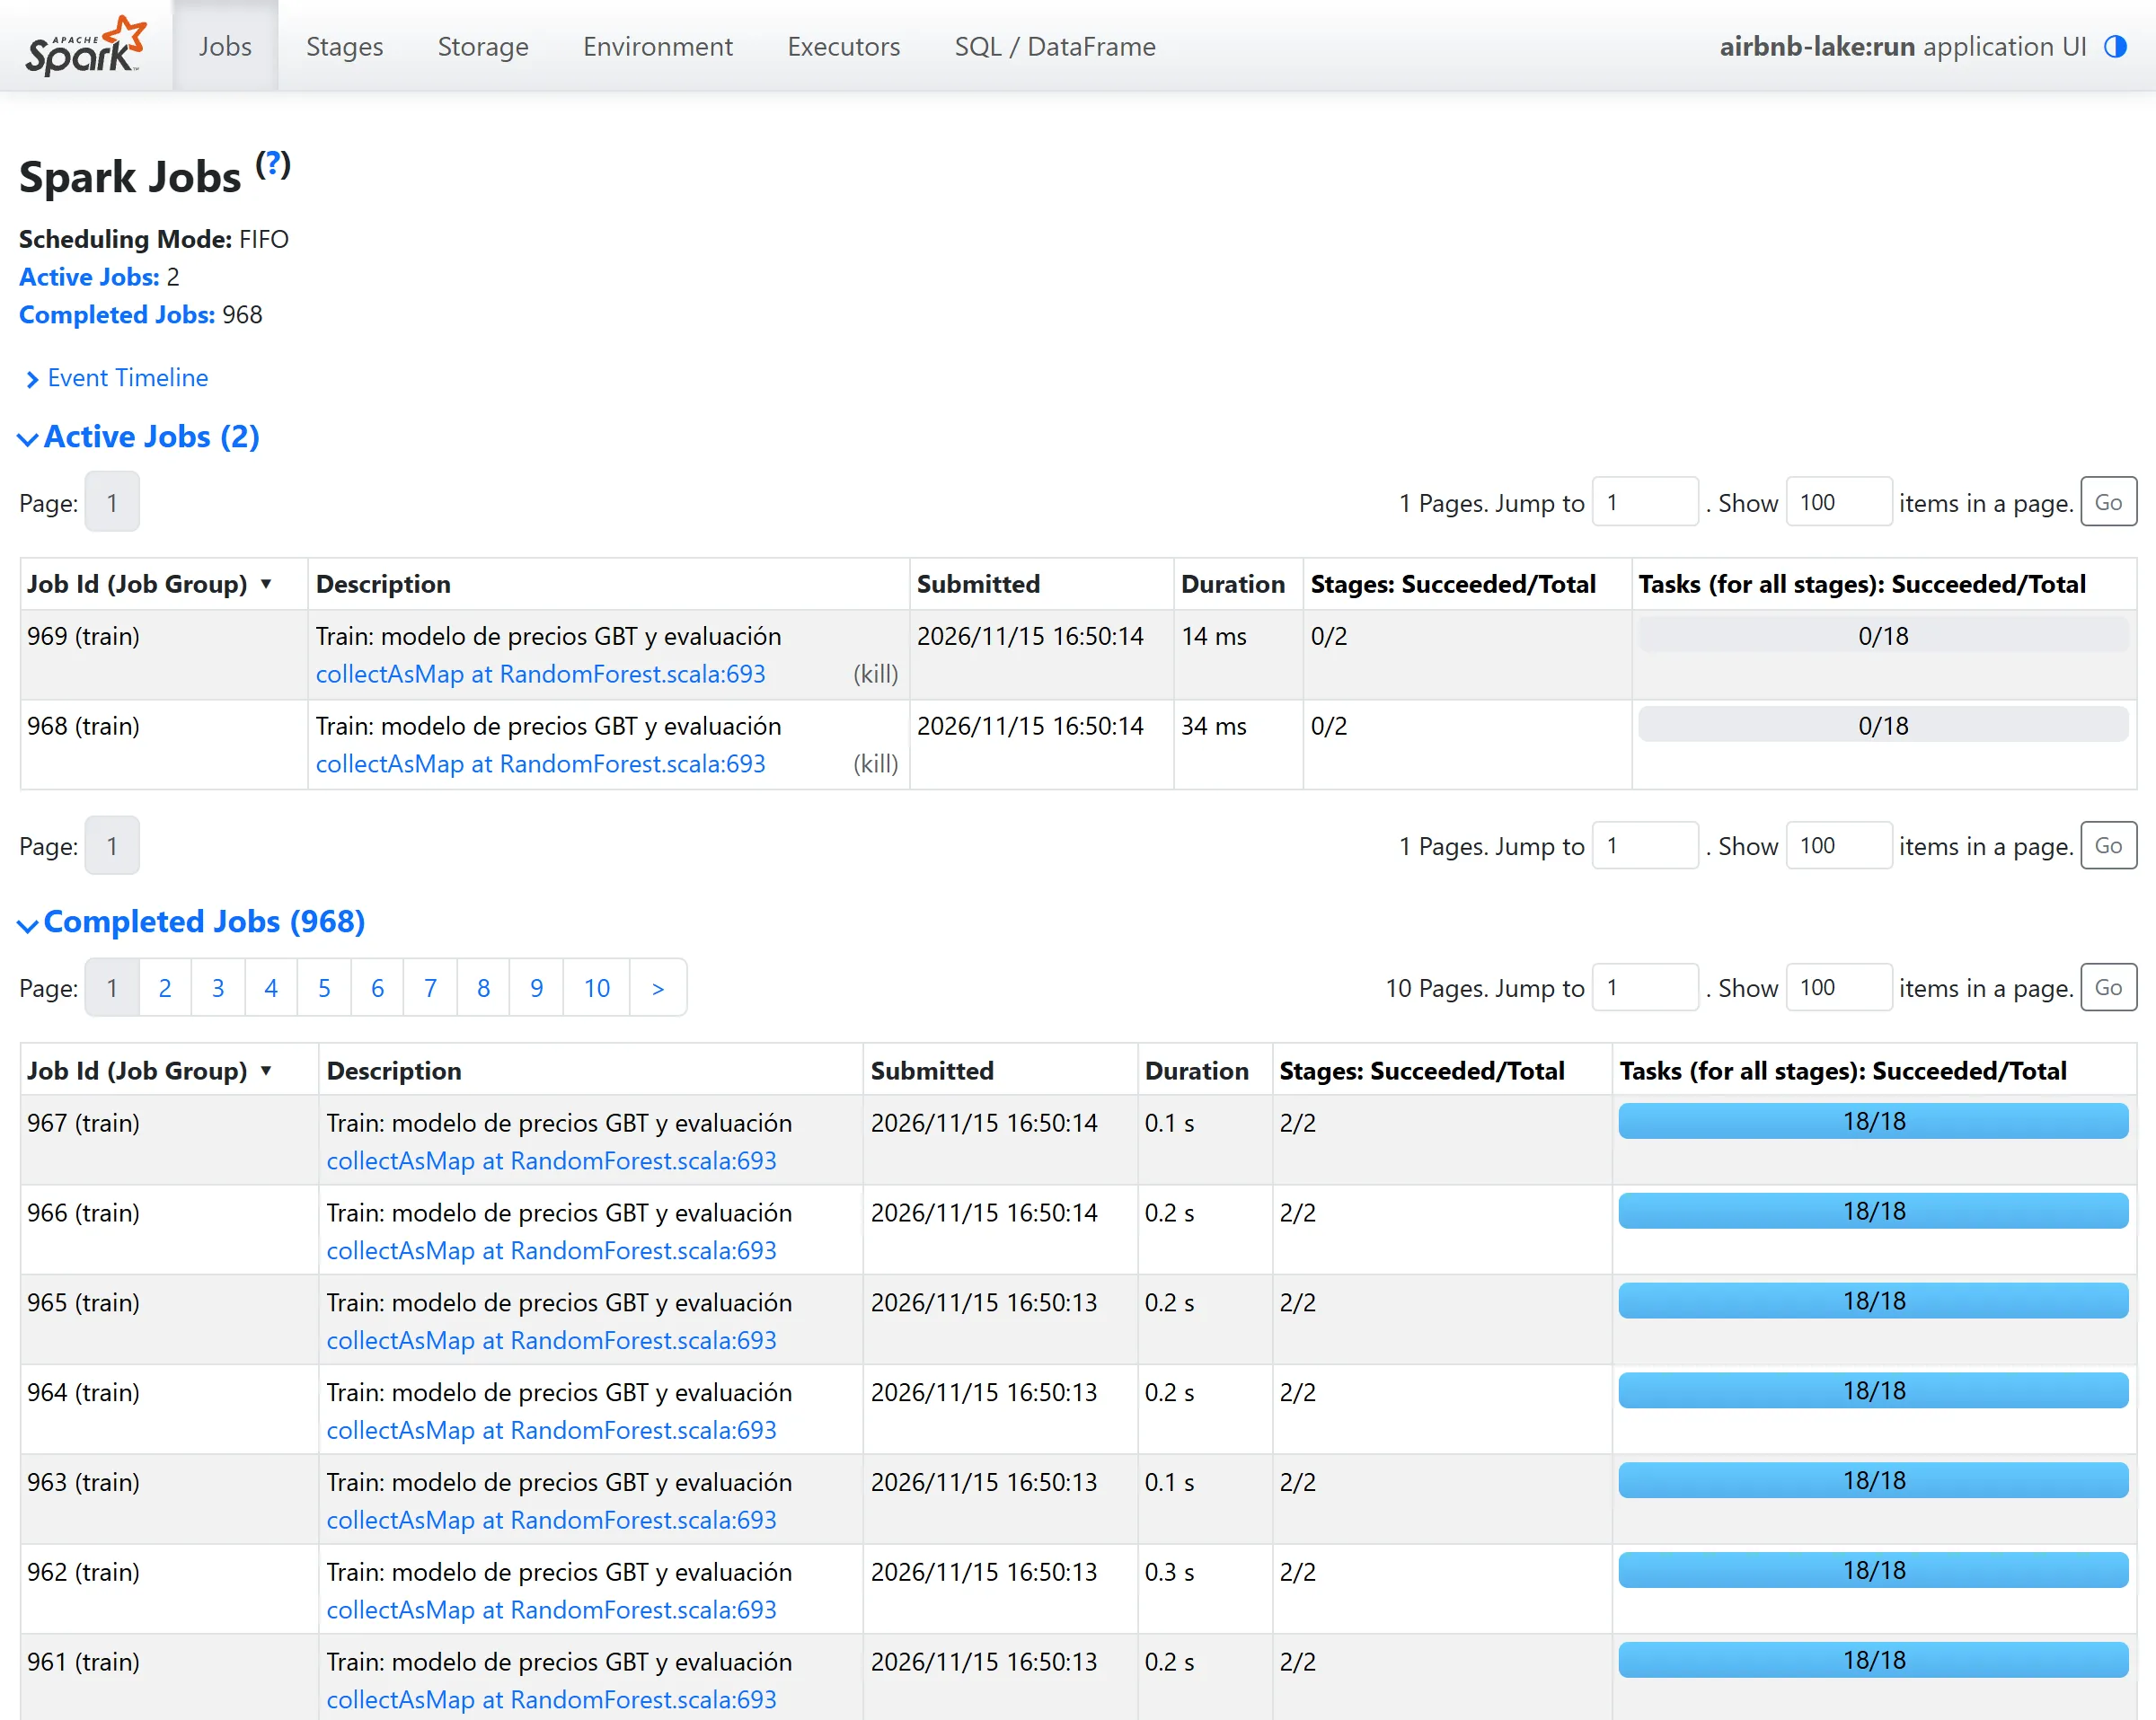
En train, el ajuste del modelo lanza cientos de jobs cortos, 937 en esta ejecución, con los diez núcleos ocupados:
Al terminar, cada zona del lake ocupa esto en HDFS:
/lake/raw      2,7 GB   archivos de la fuente, comprimidos
/lake/bronze   2,0 GB   Parquet, todo texto
/lake/silver   349 MB   Parquet con tipos; calendario por anuncio y mes
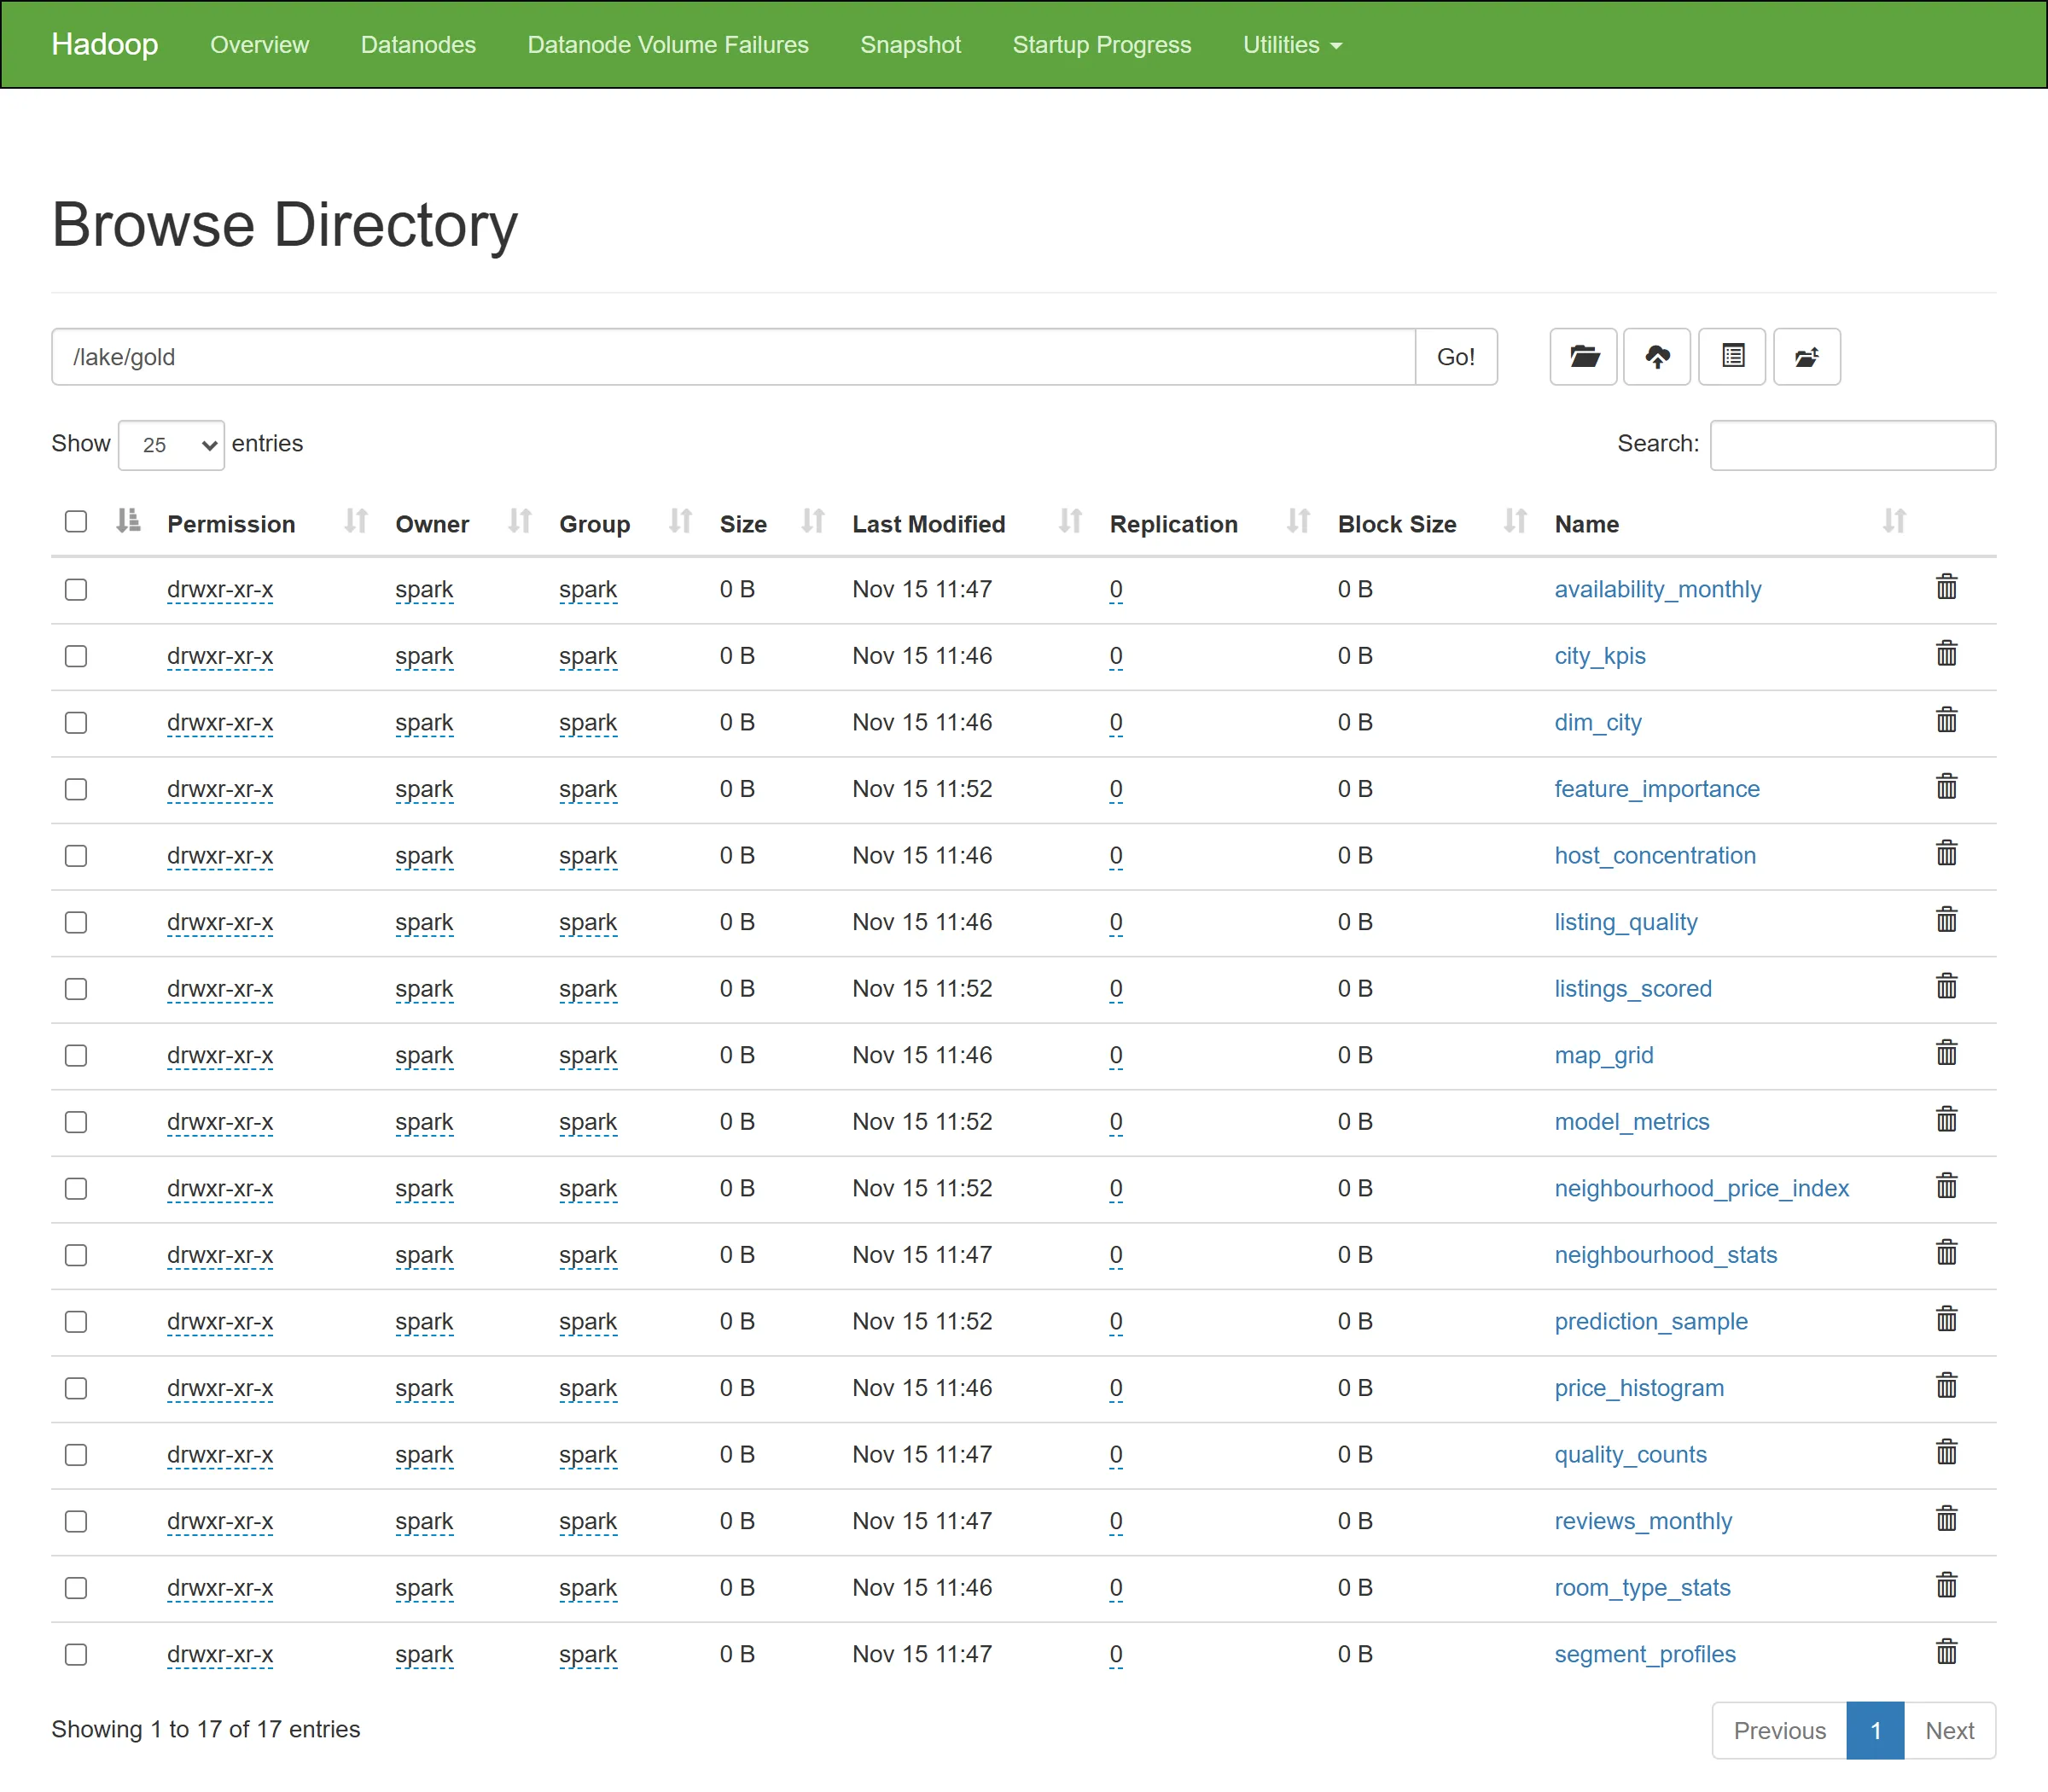
/lake/gold       7 MB   17 data marts
Esos 17 marts de Gold, aquí en el explorador del NameNode, son lo único que llega al sitio:
El modelo de precios
Un modelo de árboles potenciados por gradiente (GBT de Spark ML) predice el logaritmo del precio por noche a partir de la ciudad, la ubicación, el tamaño, el tipo de alojamiento, los servicios, el anfitrión y las reseñas. Sobre el 20 % de anuncios reservado para prueba, 69.100 anuncios, alcanza un R² de 0,83 y un error relativo mediano del 20,1 %. La regla de referencia, que predice la mediana de cada ciudad y tipo de alojamiento, se queda en 0,54 y 34,5 %.
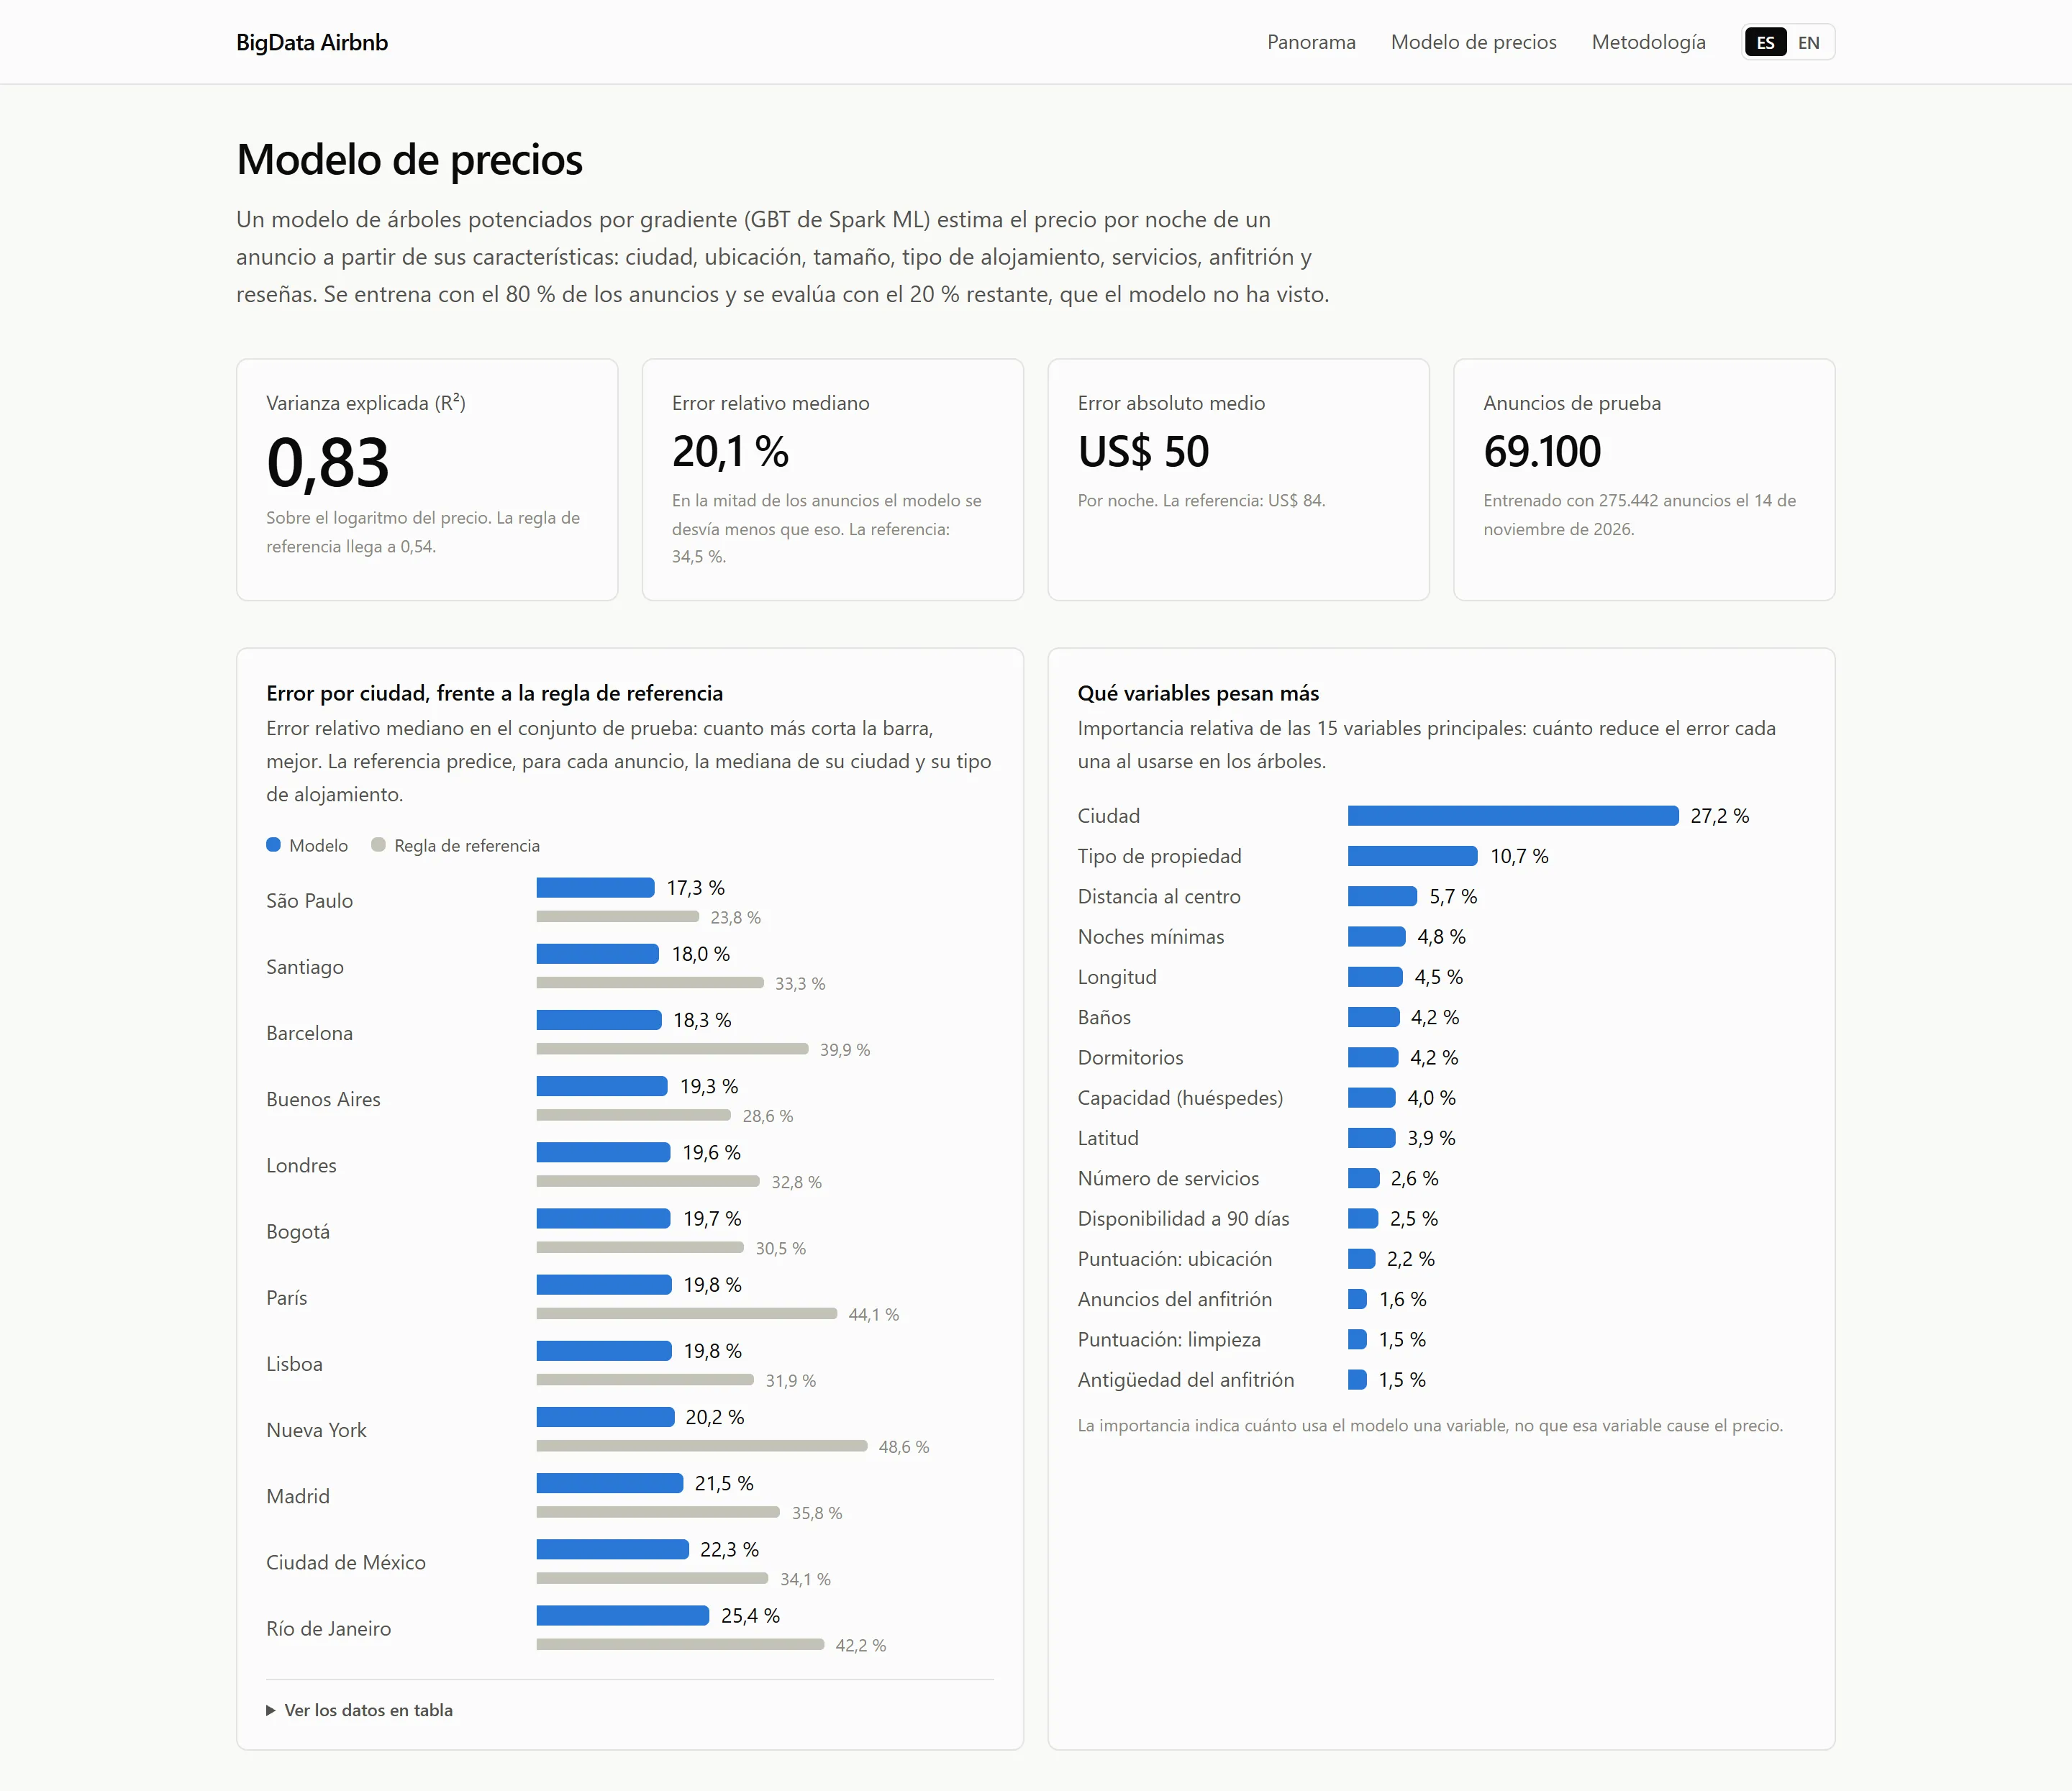
Ninguna variable se deriva del precio: hay una lista explícita de columnas prohibidas y un test que la comprueba. El reparto entre entrenamiento y prueba es determinista, por hash del identificador, así que un anuncio cae siempre en el mismo conjunto.
El modelo no acierta igual en todo el rango. Se pasa en los anuncios más baratos y se queda corto en los más caros, y el sitio lo muestra con un gráfico de sesgo por tramo de precio. Además, un K-Means agrupa los barrios de todas las ciudades por precio relativo, actividad de reseñas, disponibilidad y tipo de oferta; el número de grupos se elige con el coeficiente de silueta.
El dashboard
El sitio está hecho con Next.js y TypeScript. Las páginas se pre-renderizan a partir de los marts y se sirven desde caché, de modo que una visita normal no ejecuta ninguna consulta. Al terminar de publicar, el pipeline llama a un endpoint de revalidación y las páginas se regeneran en la siguiente visita. El sitio se conecta a la base de datos con un rol de solo lectura.
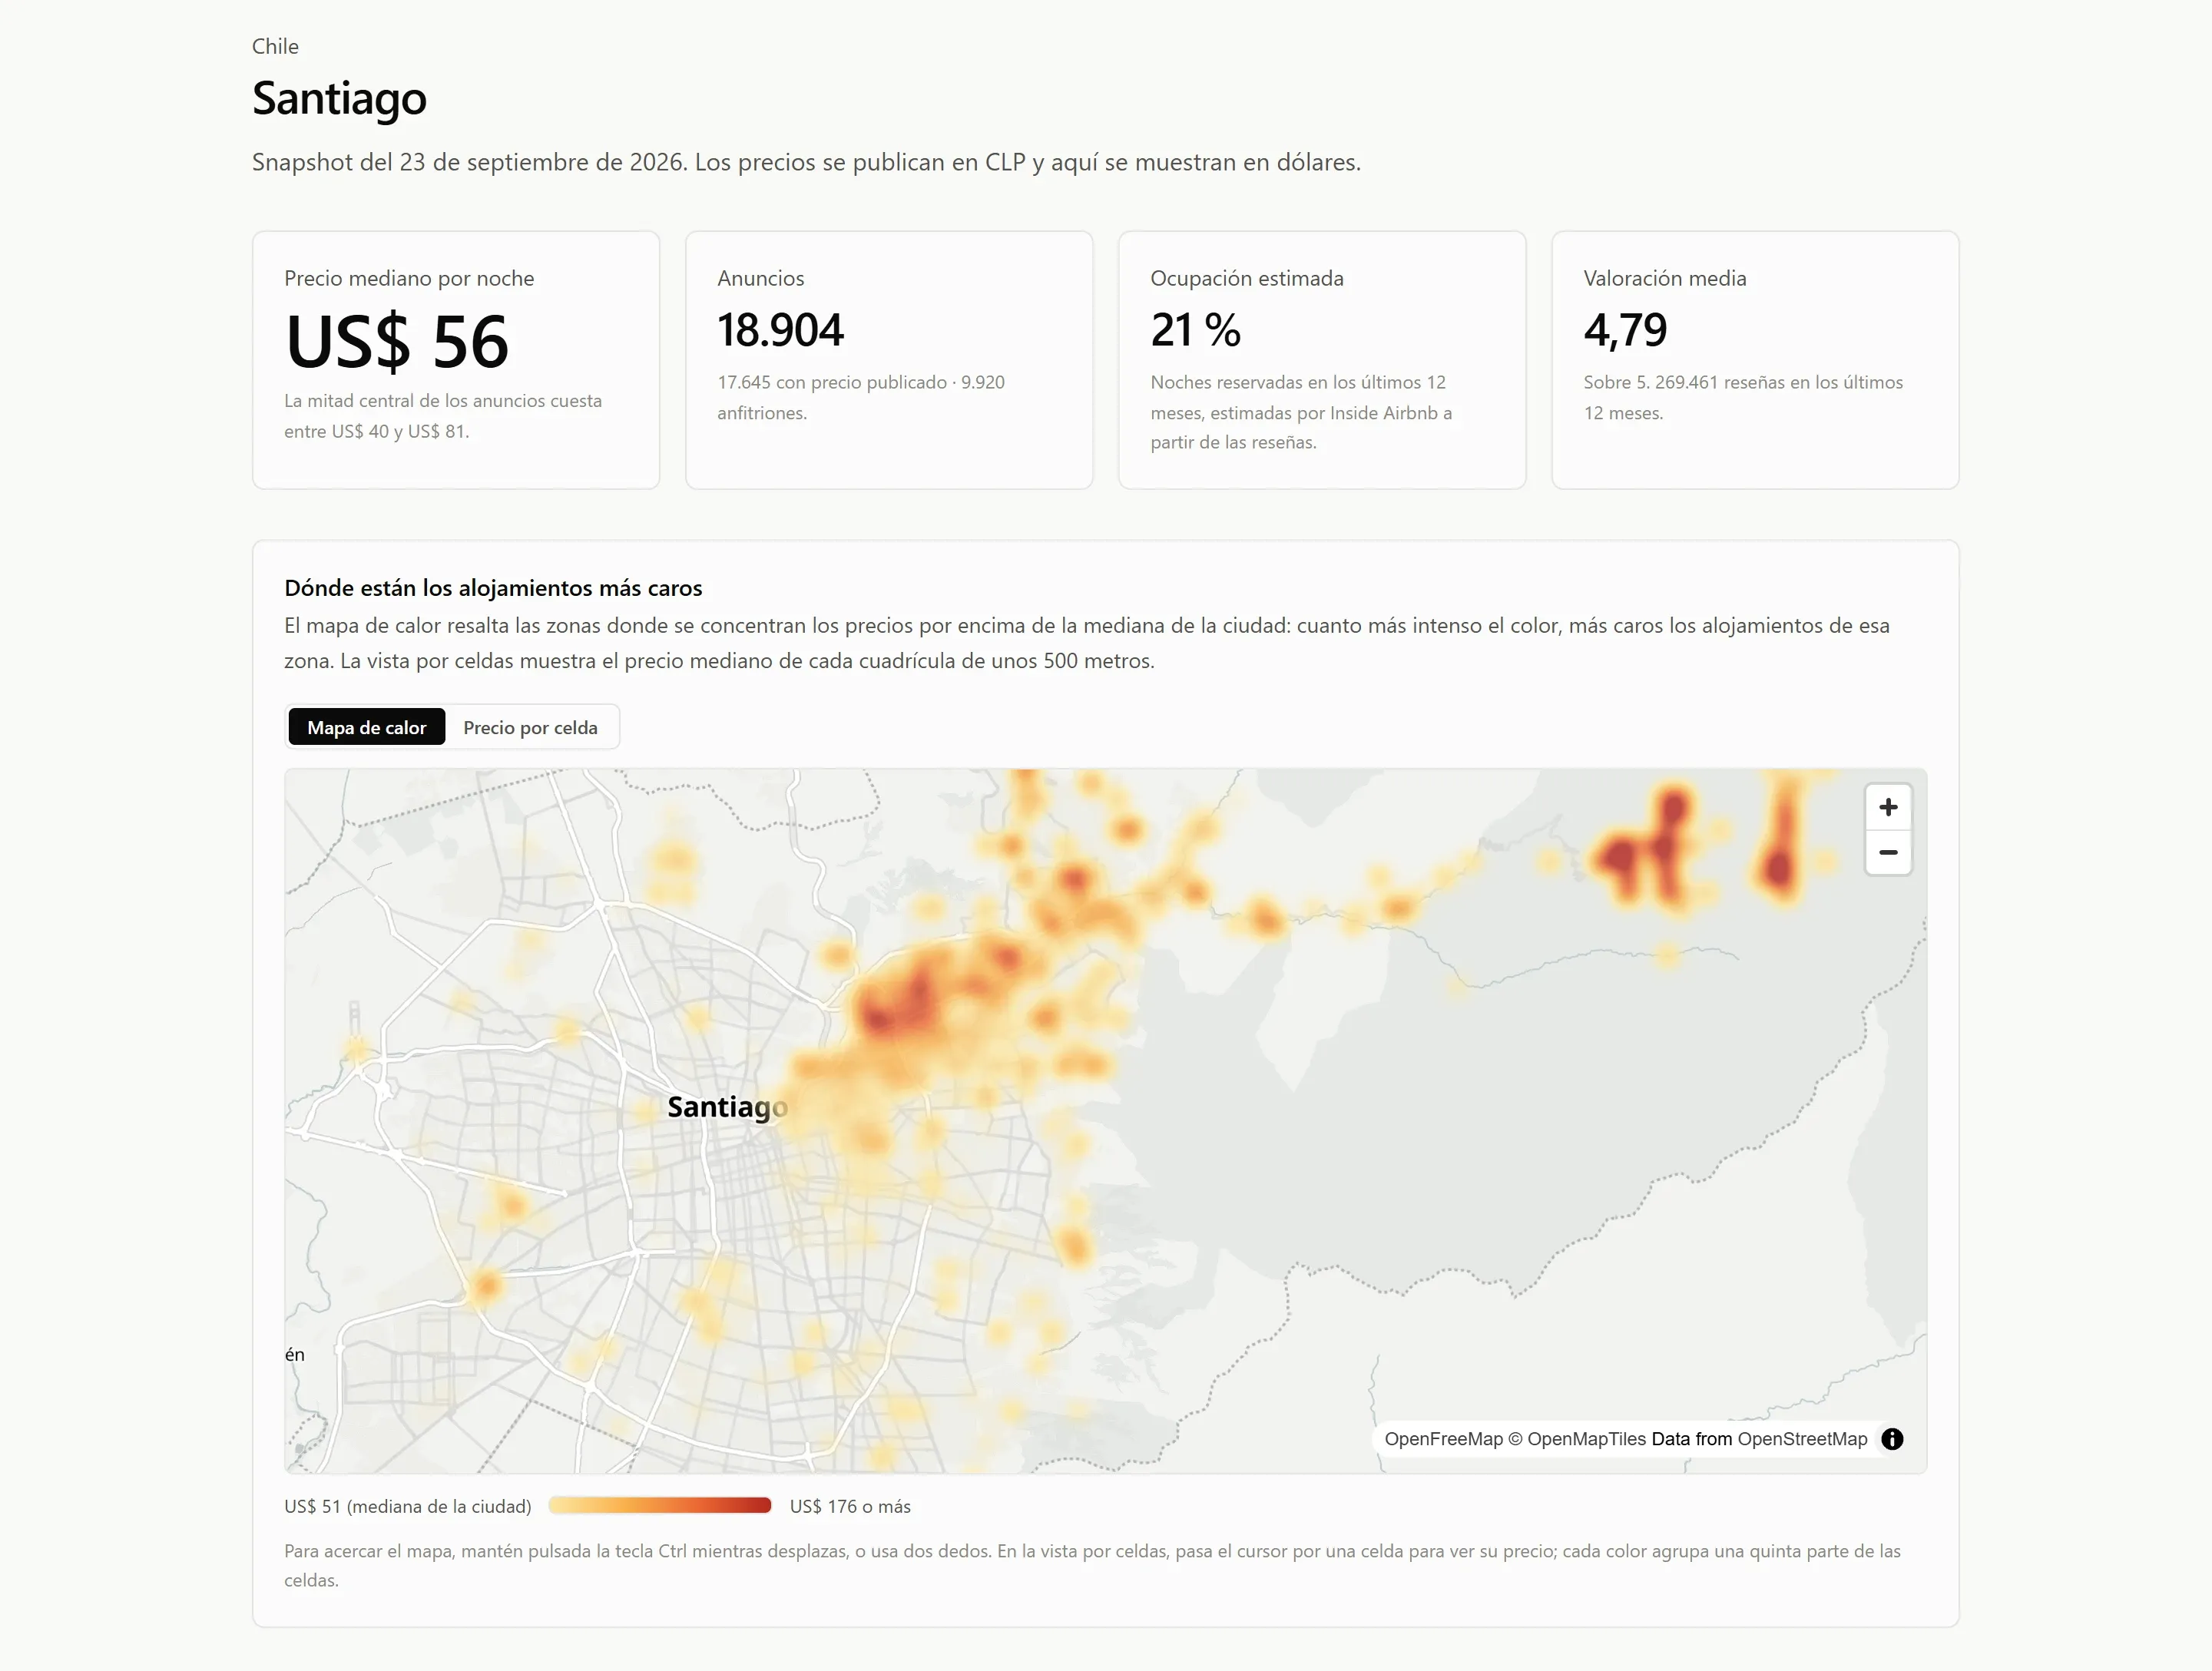
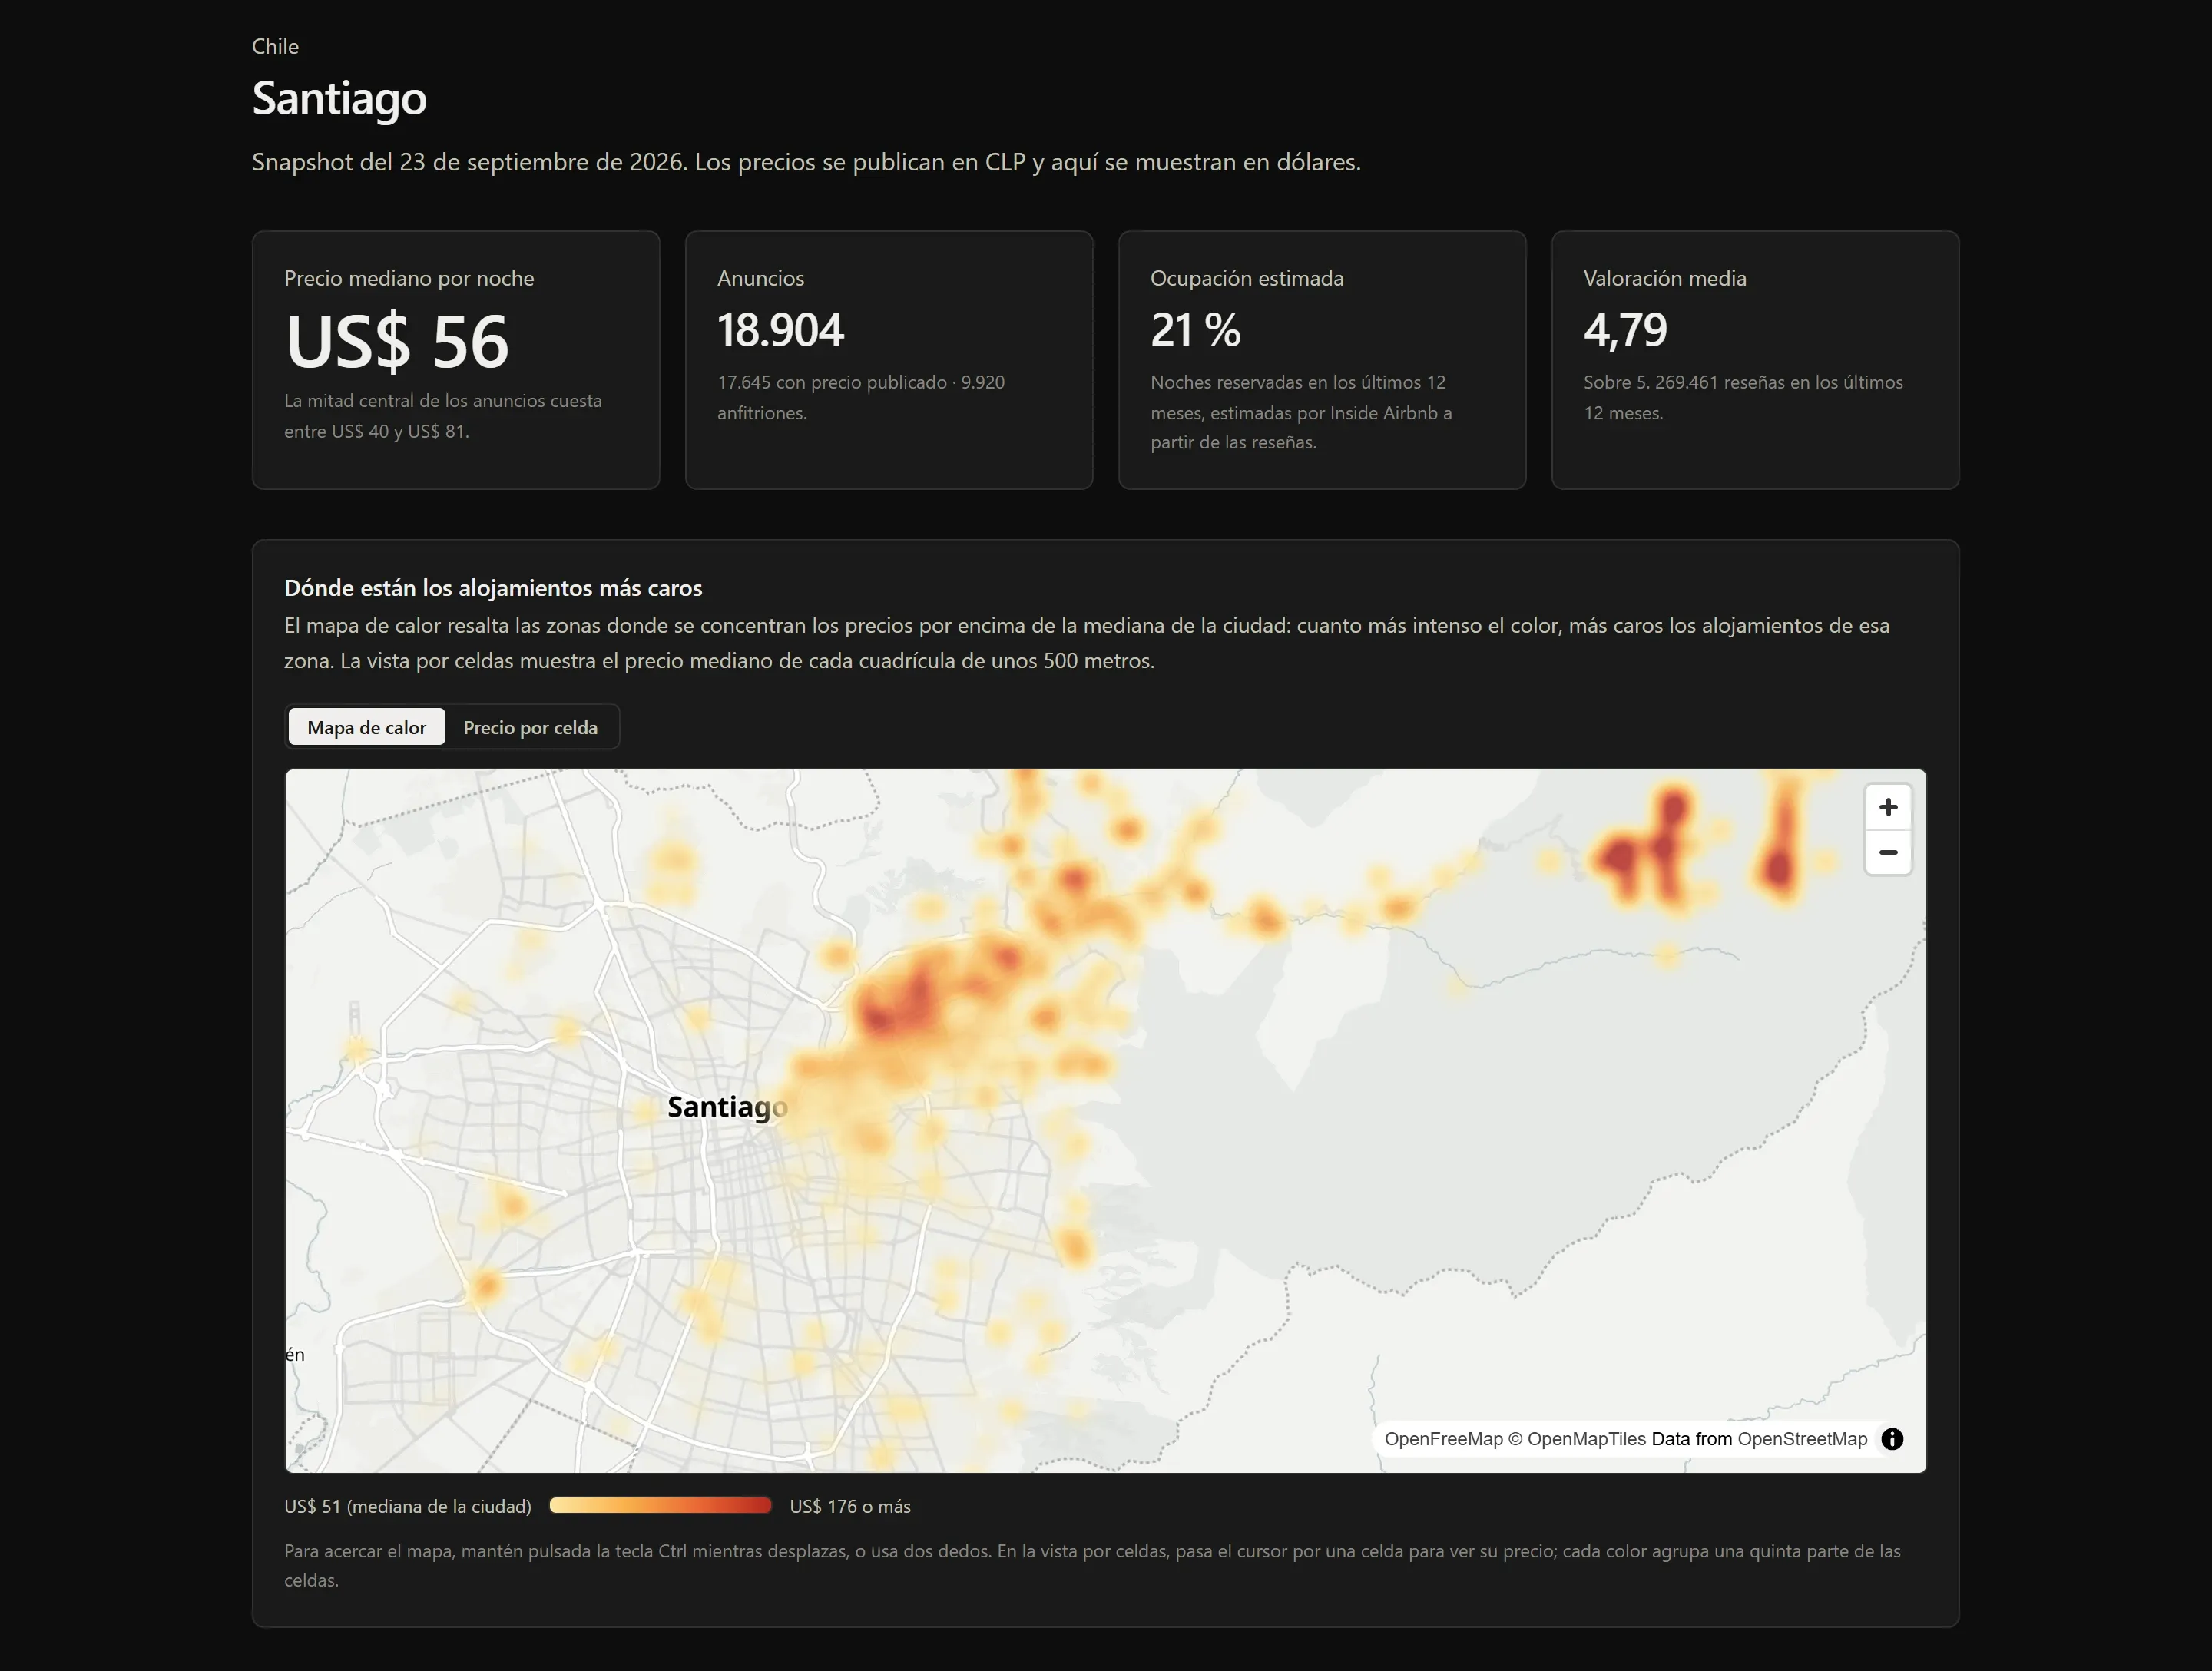
Cada ciudad tiene su página, con un mapa de precios en MapLibre GL que alterna entre mapa de calor y precio por celda de unos 500 metros:
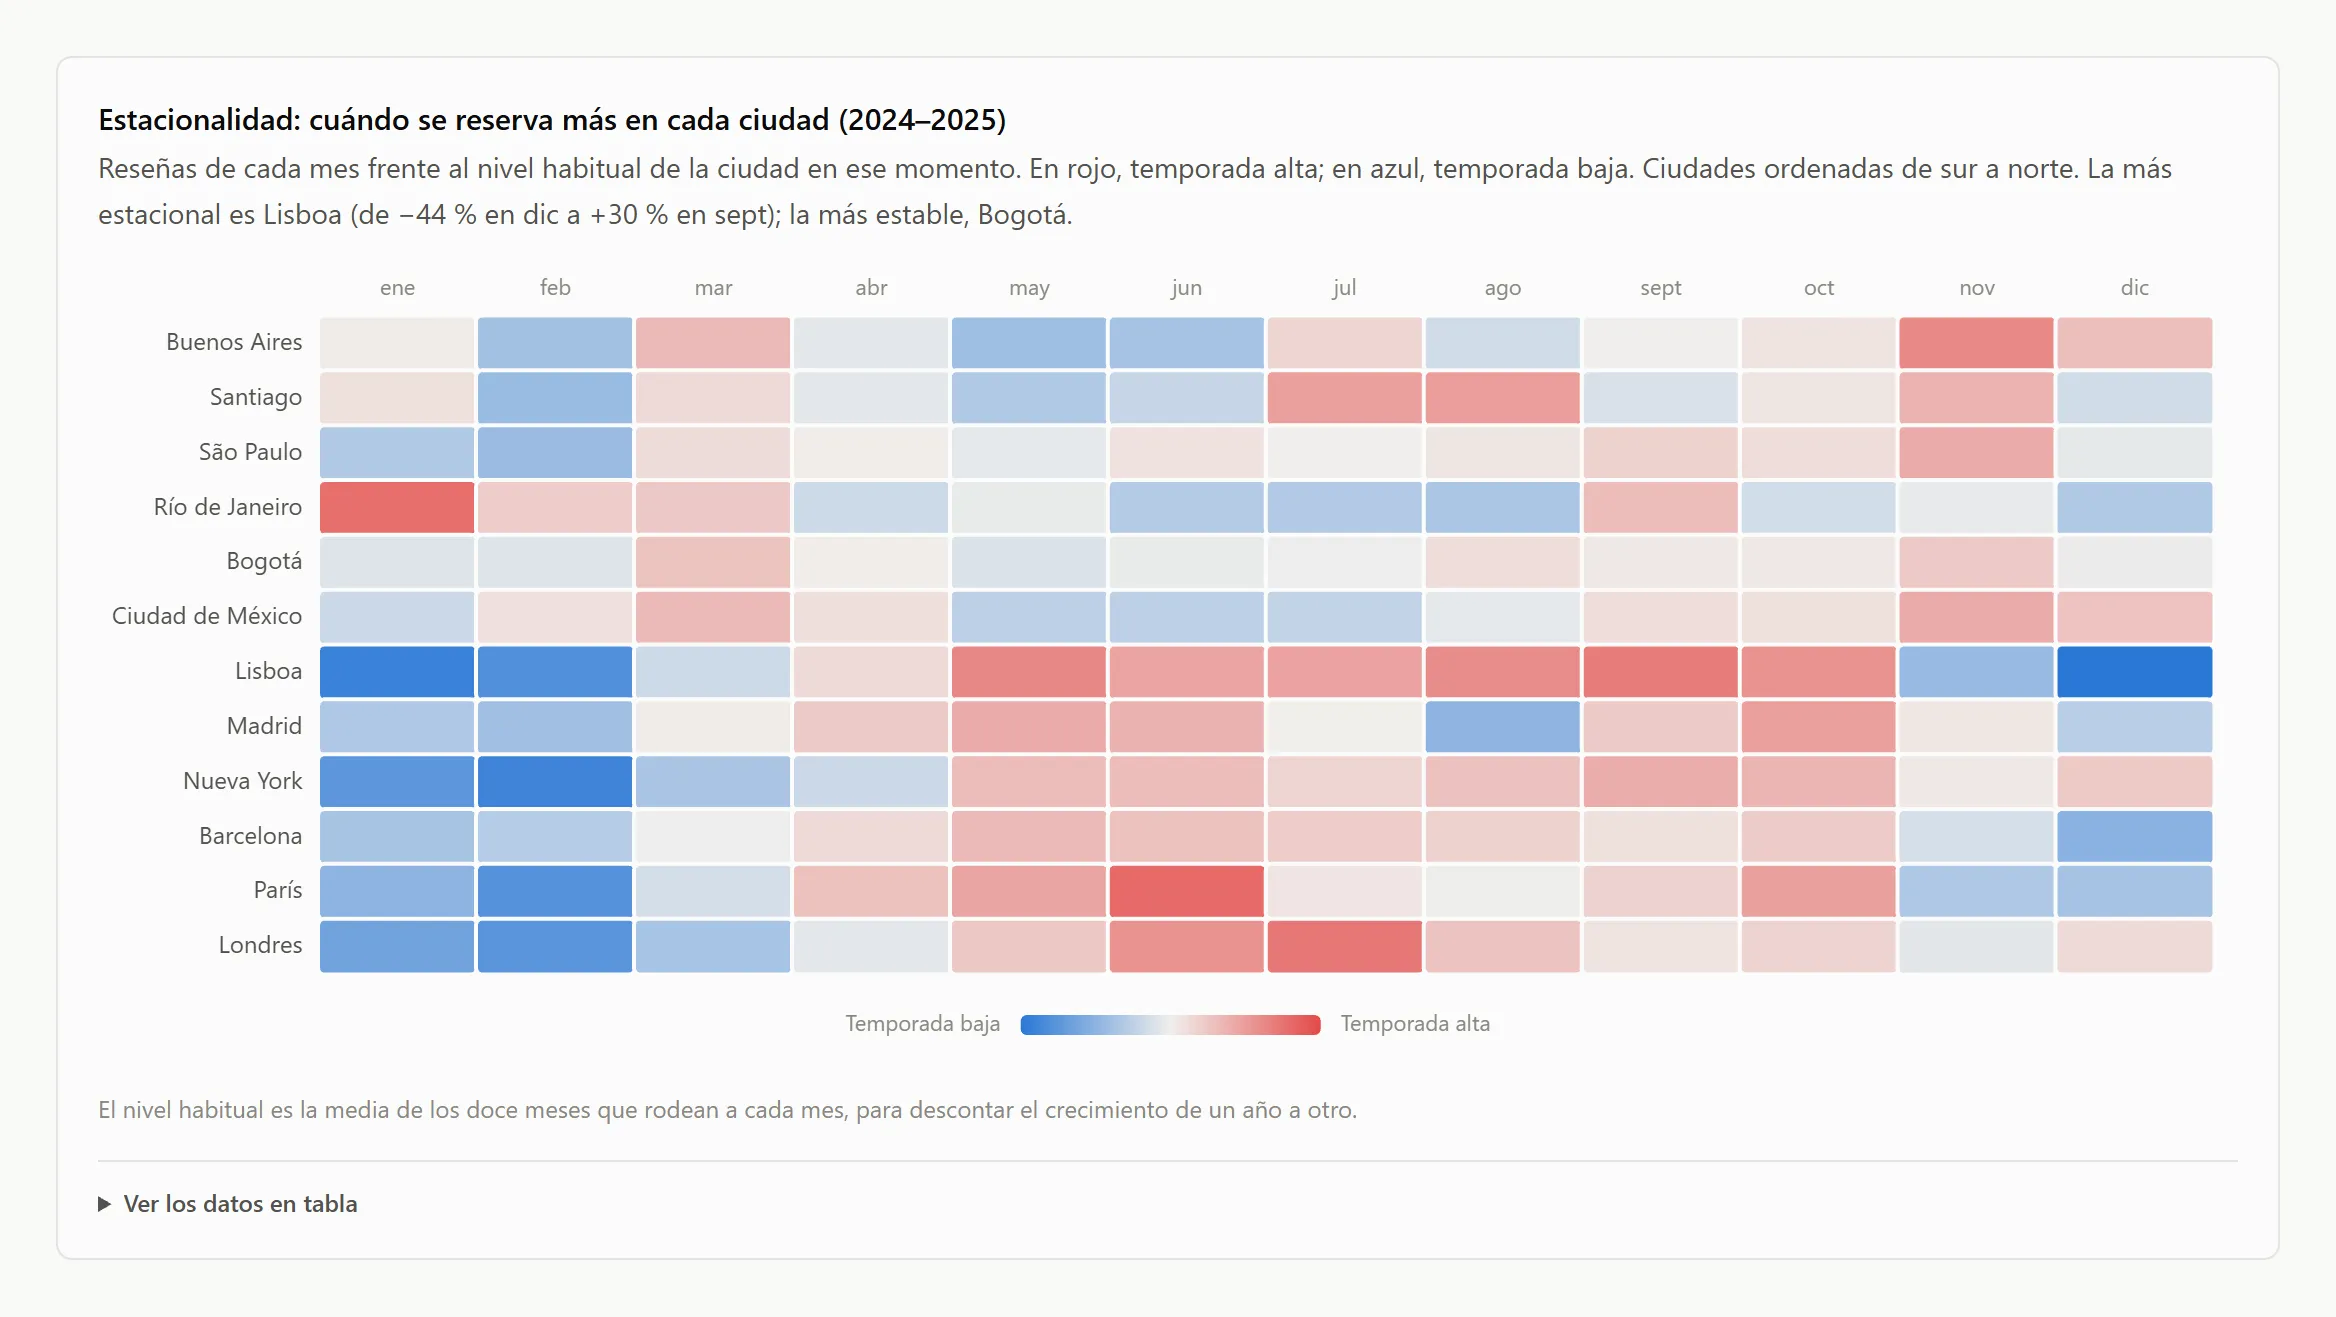
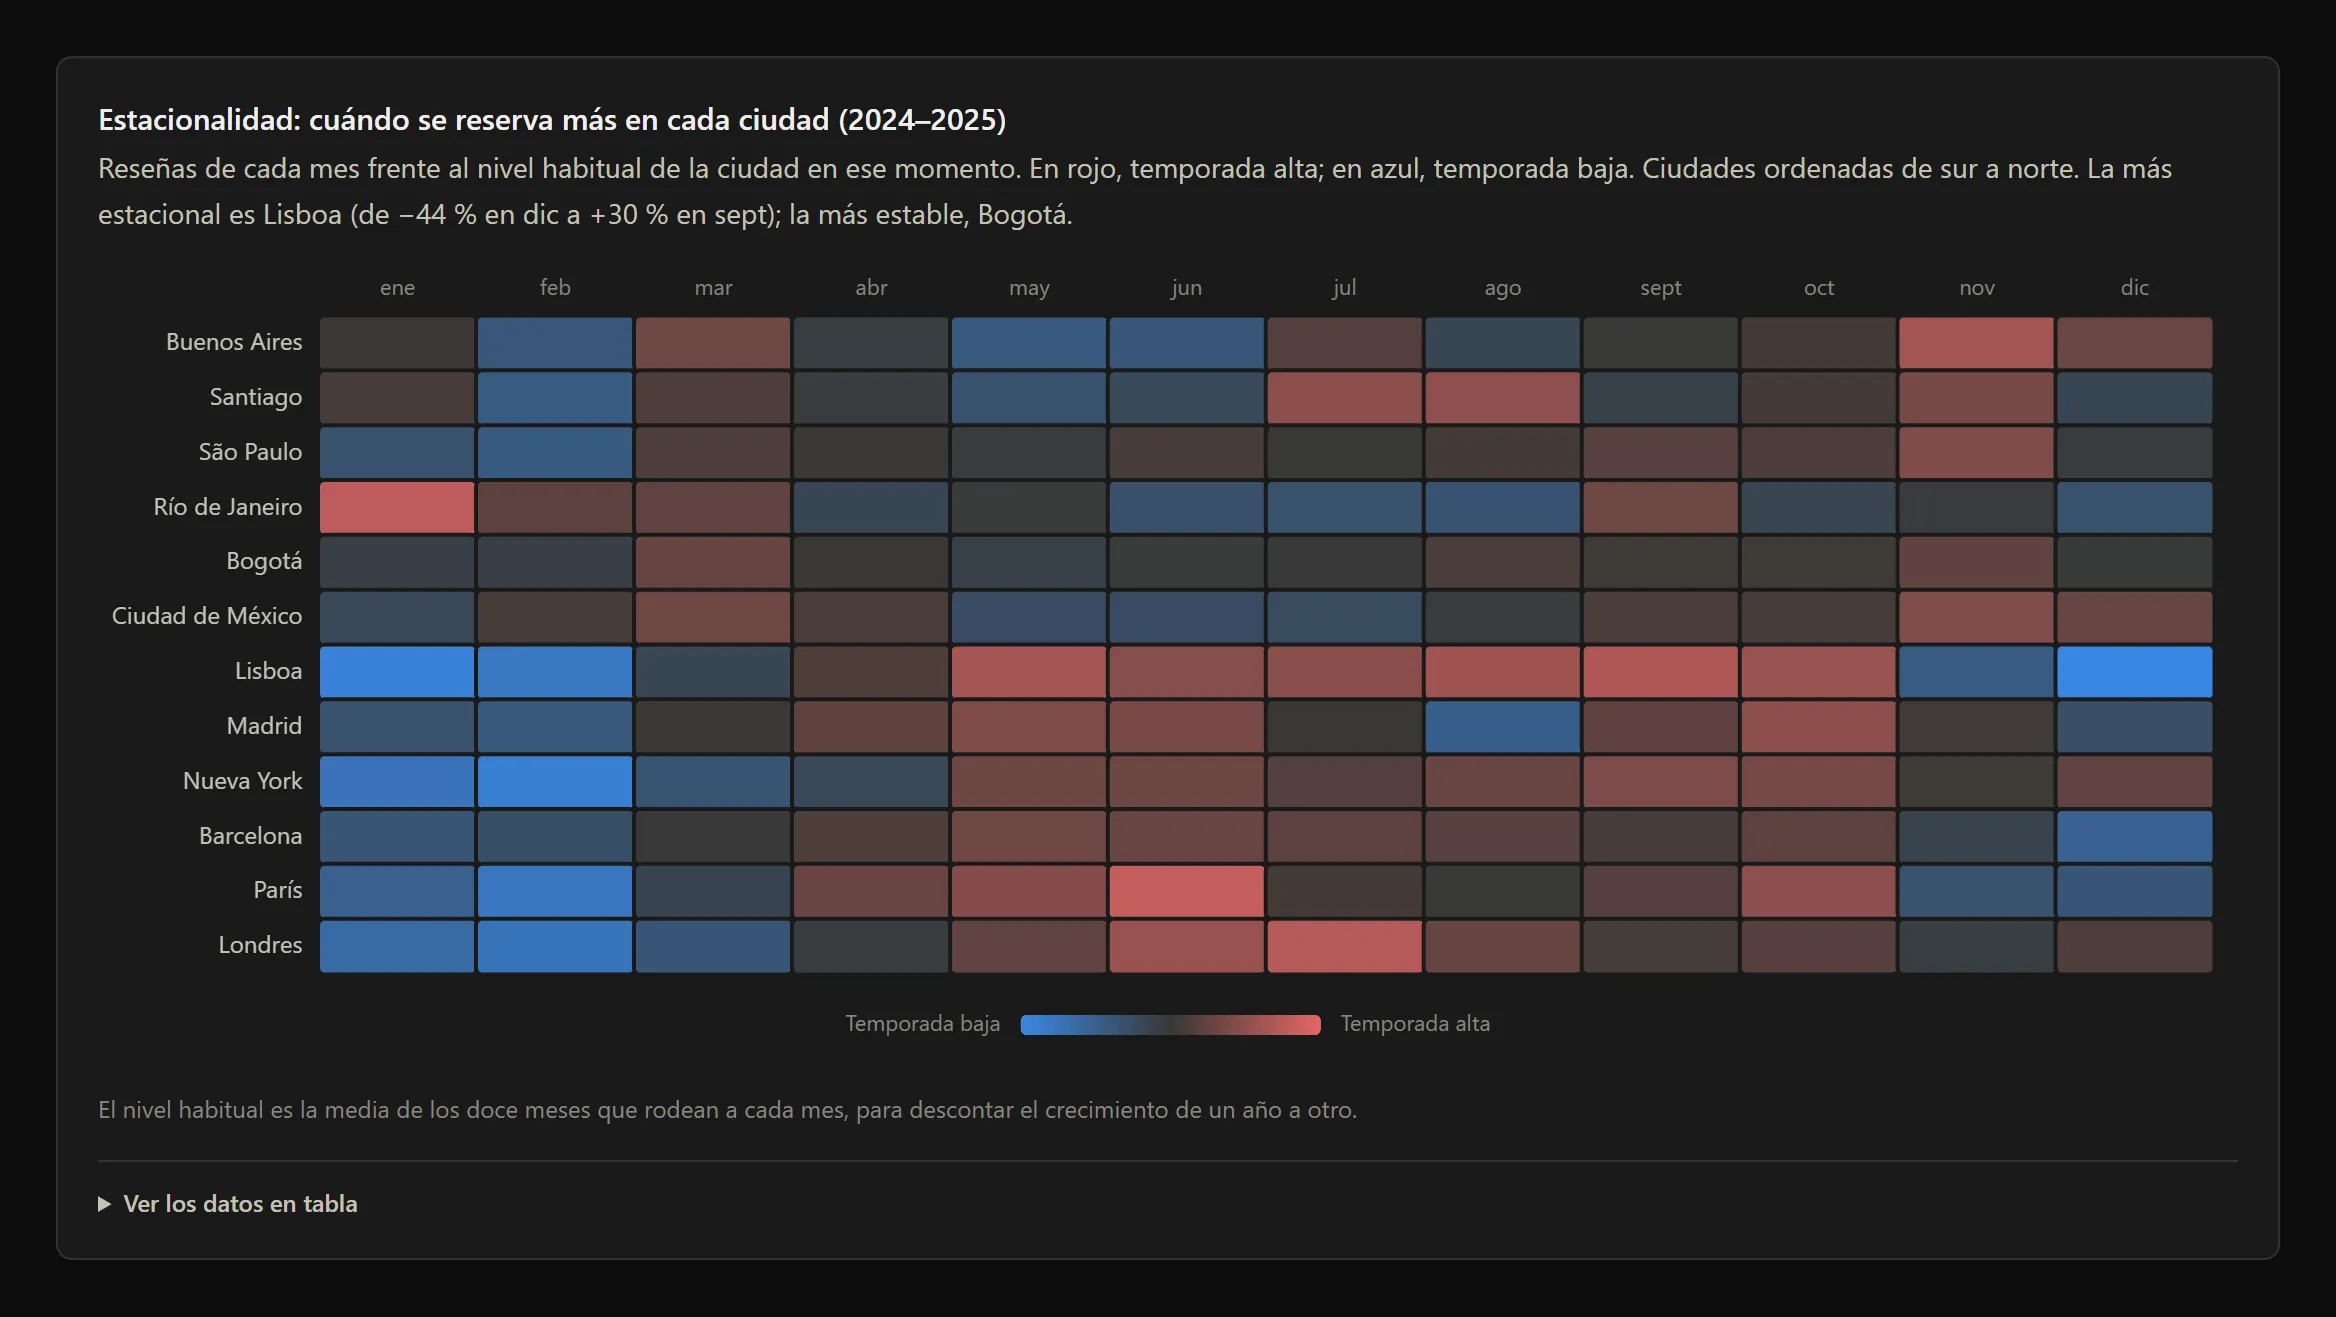
Los gráficos usan Apache ECharts, que se carga aparte para no entrar en el JavaScript inicial de ninguna página. Cada gráfico tiene su tabla equivalente, de modo que ningún valor depende solo del color ni de pasar el cursor, y la paleta está validada para daltonismo en modo claro y oscuro.
El idioma va en la dirección, con las rutas traducidas, y no se guarda en cookies.
Calidad y entrega
- Pruebas. 94 tests con pytest y Spark en modo local, incluidos un recorrido completo sobre un lake temporal y la publicación en PostgreSQL, donde se comprueban la atomicidad de la carga y los permisos del rol de solo lectura.
- Análisis estático.
ruffymypyen modo estricto en el pipeline; ESLint y TypeScript en el sitio. - CI. GitHub Actions ejecuta lint, tipos y tests del pipeline, y lint, tipos y build del dashboard, en cada pull request.
- Pruebas de humo. Playwright recorre el sitio en escritorio, modo oscuro y móvil, y las mismas pruebas se pueden lanzar contra el sitio desplegado.
- Infraestructura. La base de datos en Neon, el proyecto en Vercel y el DNS están definidos con Terraform en un repositorio aparte.
De la versión original a la actual
- De una ciudad con un CSV resumido de 18 columnas a 12 ciudades con los archivos detallados de 90 columnas, el calendario y las reseñas.
- De cargar cada CSV en memoria con pandas y reenviarlo fila a fila por Kafka a una descarga en streaming directa al lake.
- De no tener capa Silver ni particionado, con datos duplicados en cada reejecución, a capas persistidas, particionadas e idempotentes.
- De un modelo con un R² cercano a cero a uno de 0,83 sin fuga del objetivo.
- De abrir a mano un archivo Parquet en Power BI a un sitio web con datos pre-agregados y caché.
- De no tener pruebas a 94 tests, tipos estrictos y CI.
El código de la primera versión se conserva en la carpeta legacy/ del repositorio, con su autoría.
Límites
- Los precios son los anunciados, y muchos anuncios no publican precio (en París, el 44 %). Las estadísticas de precio y el modelo usan solo los que sí.
- La conversión a dólares usa un tipo de cambio fijo, para que repetir una ejecución dé el mismo resultado.
- La ocupación es una estimación de Inside Airbnb a partir de las reseñas.
- El clúster local tiene un solo DataNode, sin réplicas: sirve para desarrollar y demostrar, no para conservar datos.
Los datos proceden de Inside Airbnb y se usan bajo la licencia CC BY 4.0. El sitio publica solo agregados, sin nombres de anfitriones ni texto de reseñas. El proyecto es independiente y no está afiliado a Airbnb ni a Inside Airbnb.